HF 論文速讀 2026-08-08
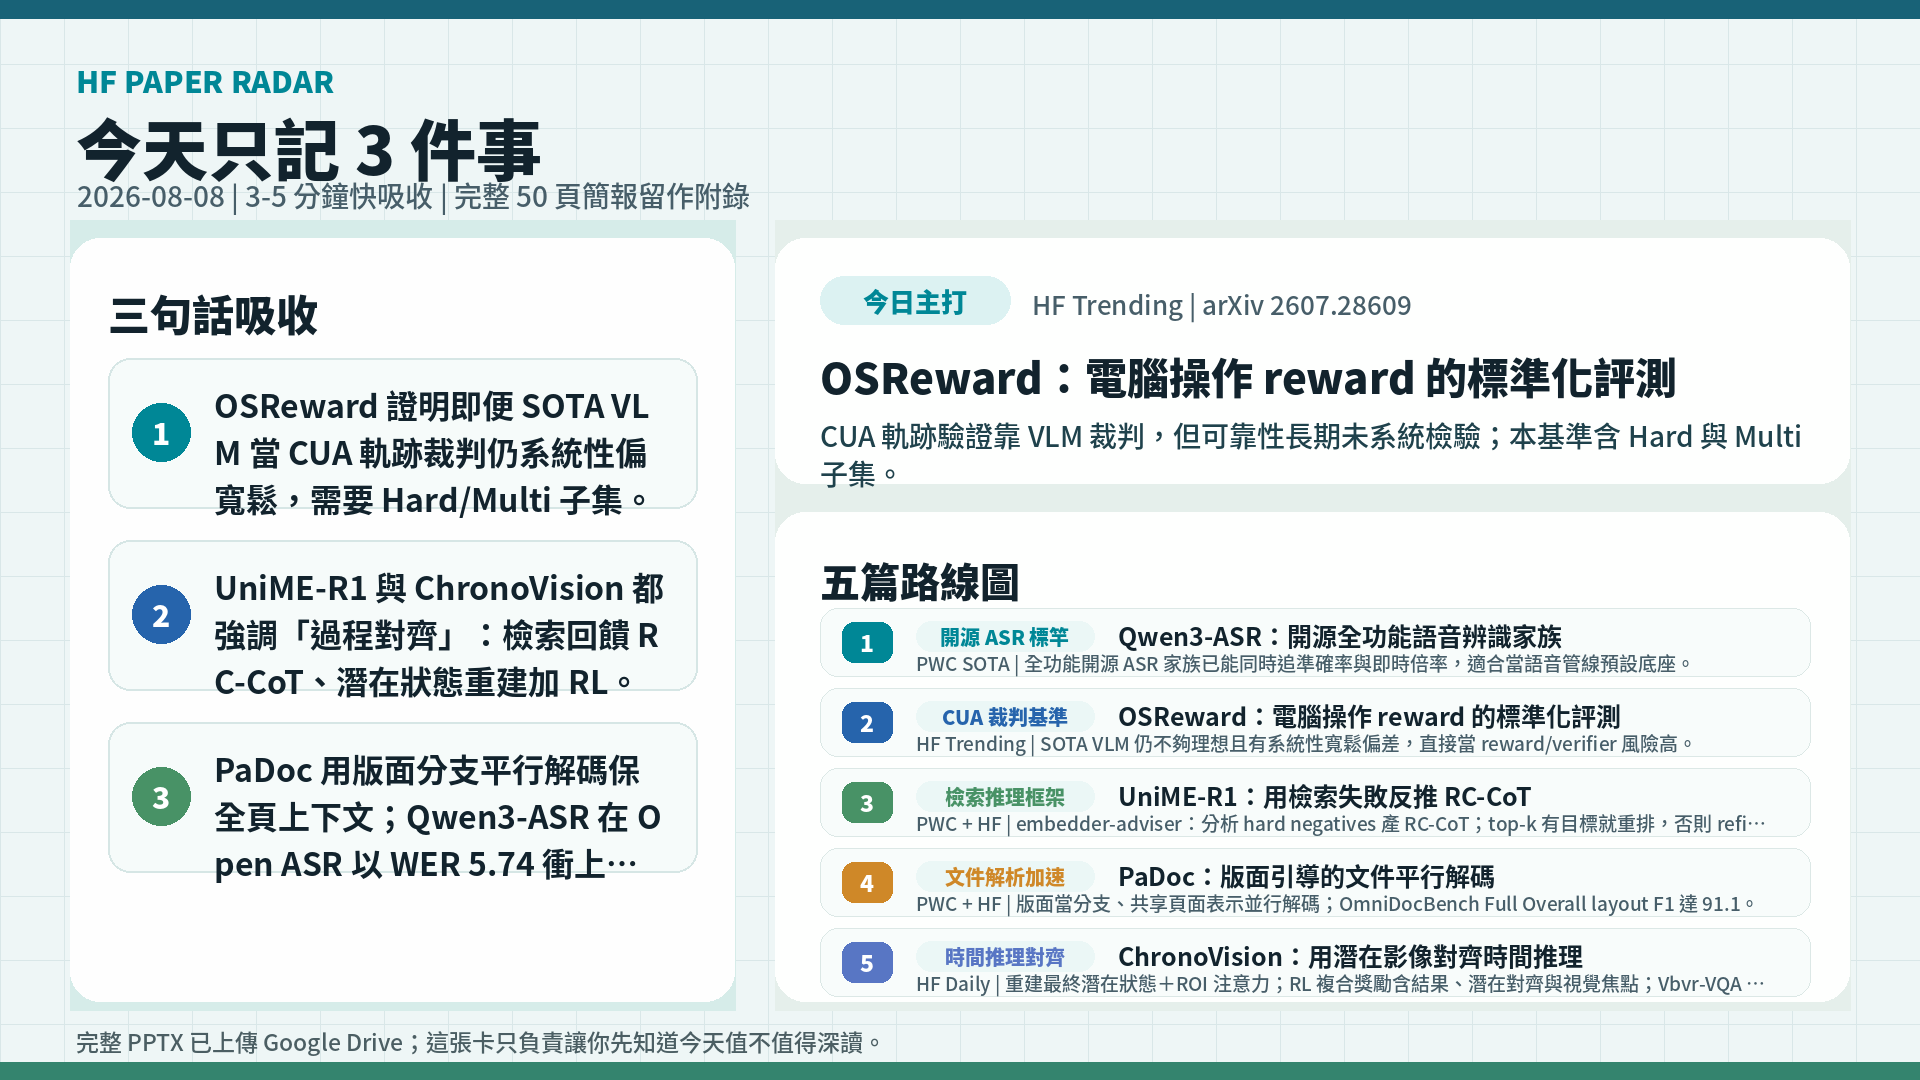
多模態從「會看」走向可驗證:評測標準、失敗驅動推理、平行文件解析與時間潛在對齊齊發。
今天重點是:用標準化基準拆穿 VLM 裁判偏鬆、用檢索失敗與潛在影像對齊補強推理,再加開源 ASR 與文件平行解碼把效率拉滿。
今天先記三件事
- OSReward 證明即便 SOTA VLM 當 CUA 軌跡裁判仍系統性偏寬鬆,需要 Hard/Multi 子集。
- UniME-R1 與 ChronoVision 都強調「過程對齊」:檢索回饋 RC-CoT、潛在狀態重建加 RL。
- PaDoc 用版面分支平行解碼保全頁上下文;Qwen3-ASR 在 Open ASR 以 WER 5.74 衝上第一。
五篇速讀
Qwen3-ASR:開源全功能語音辨識家族
開源 ASR 標竿
為什麼重要:Open ASR Leaderboard 以 WER 5.74、RTFx 796.19 居冠,實用吞吐與準確率兼具。
帶走什麼:全功能開源 ASR 家族已能同時追準確率與即時倍率,適合當語音管線預設底座。
下一步:對照自家測試集測 WER/延遲,評估是否替換現有 Whisper 系或商用 ASR。
OSReward:電腦操作 reward 的標準化評測
CUA 裁判基準
為什麼重要:CUA 軌跡驗證靠 VLM 裁判,但可靠性長期未系統檢驗;本基準含 Hard 與 Multi 子集。
帶走什麼:SOTA VLM 仍不夠理想且有系統性寬鬆偏差,直接當 reward/verifier 風險高。
下一步:做 CUA RL 或資料篩選前,先用 OSReward 測你的 VLM judge 寬鬆度與失敗模式。
UniME-R1:用檢索失敗反推 RC-CoT
檢索推理框架
為什麼重要:純 query 端 CoT 只解釋意圖,不解釋檢索器搞混什麼;需以回饋條件化推理。
帶走什麼:embedder-adviser:分析 hard negatives 產 RC-CoT;top-k 有目標就重排,否則 refining 再檢。
下一步:統一多模態檢索管線可加「初檢失敗→顧問推理→再檢」兩段式,優先挖混淆對。
PaDoc:版面引導的文件平行解碼
文件解析加速
為什麼重要:端到端自迴歸序列隨總內容變長;兩階段裁切又失全頁上下文與重複 prefill。
帶走什麼:版面當分支、共享頁面表示並行解碼;OmniDocBench Full Overall layout F1 達 91.1。
下一步:文件解析若瓶頸在解碼深度,評估 layout-grounded 平行解碼與 vLLM 前綴快取。
ChronoVision:用潛在影像對齊時間推理
時間推理對齊
為什麼重要:語言推理難精準描述連續視覺變換,多步時間推理易崩;需潛在影像過程對齊。
帶走什麼:重建最終潛在狀態+ROI 注意力;RL 複合獎勵含結果、潛在對齊與視覺焦點;Vbvr-VQA 域內 74.8%、域外 71.6%。
下一步:影片/時序 VQA 可試 latent reconstruction 輔助頭,並用影像排序式任務壓力測。