HF 論文速讀 2026-08-09
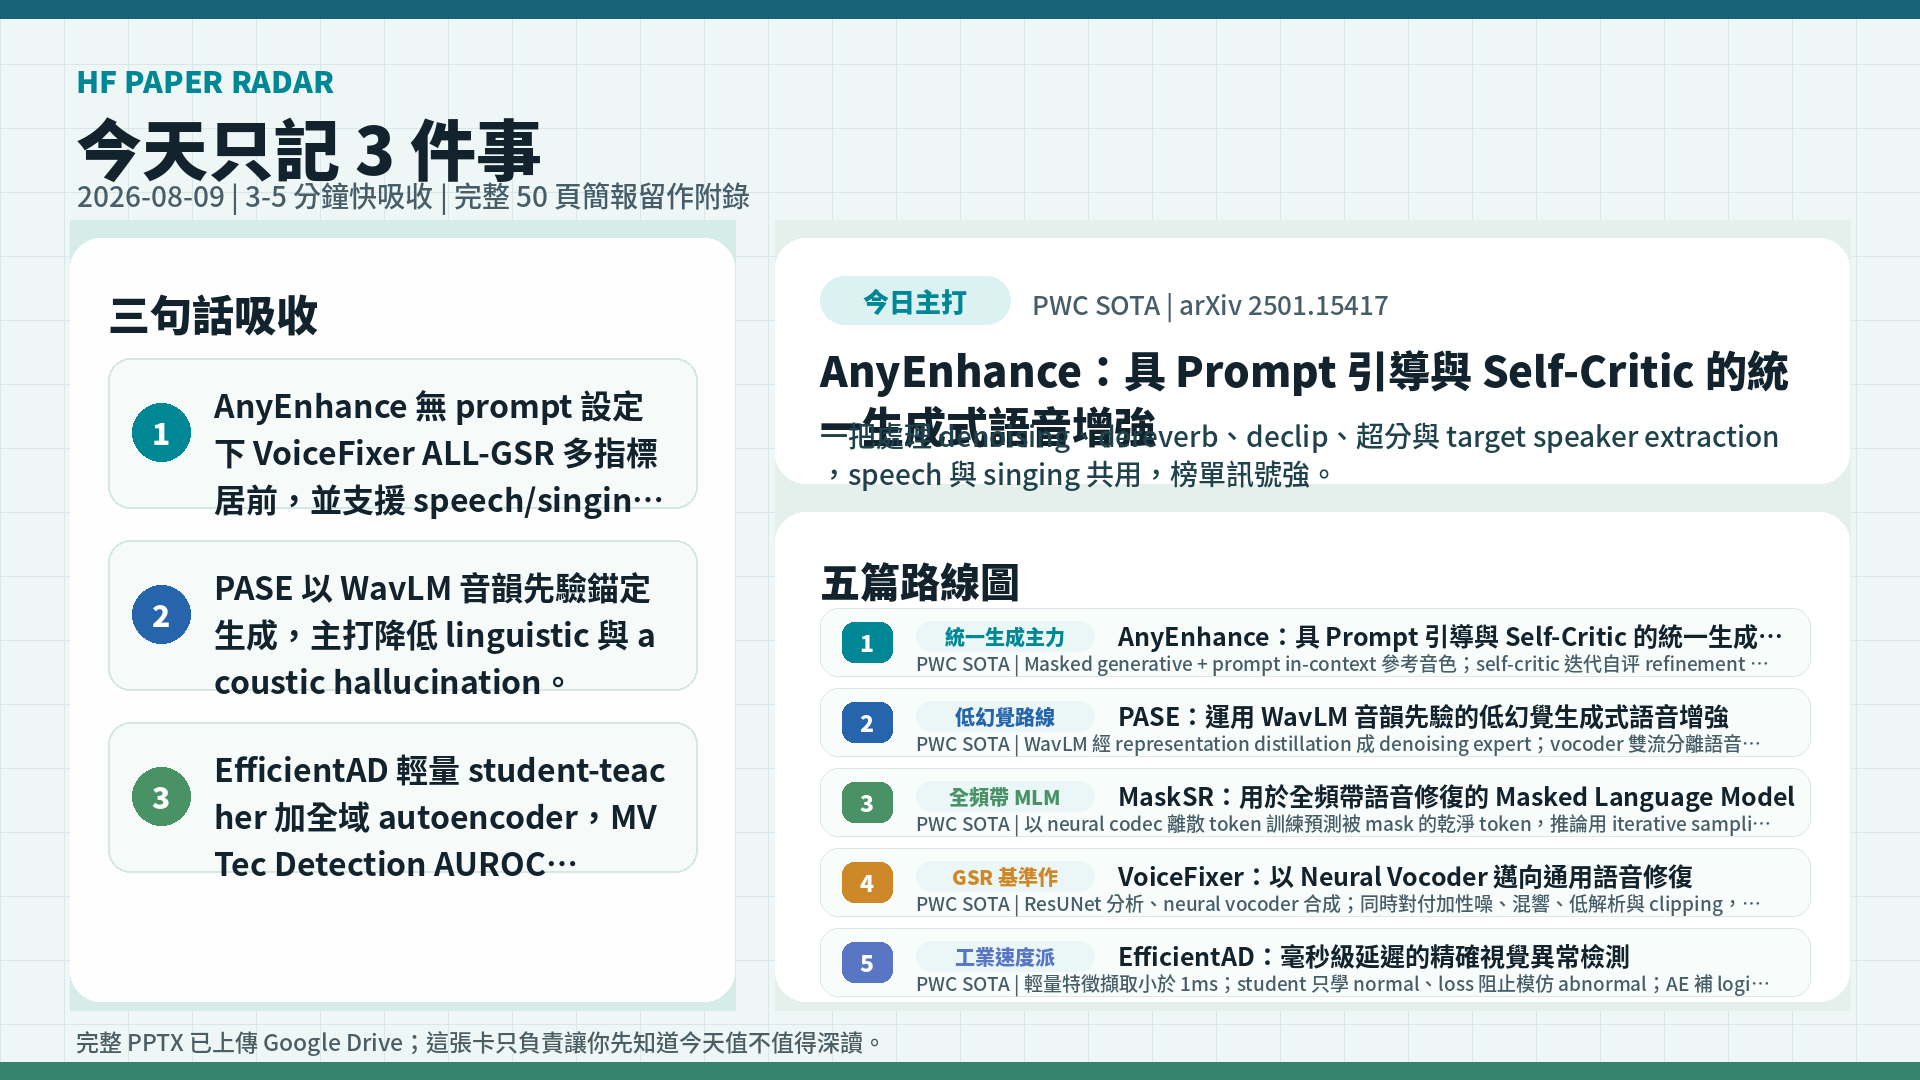
生成式語音修復主打低幻覺與多失真一模型統修,旁支工業視覺異常檢測拚毫秒級延遲。
先看 AnyEnhance 的 prompt 與 self-critic 統一增強;PASE 用 WavLM 音韻先驗壓幻覺;EfficientAD 證明工業 anomaly 可做到約 2ms。
今天先記三件事
- AnyEnhance 無 prompt 設定下 VoiceFixer ALL-GSR 多指標居前,並支援 speech/singing 多…
- PASE 以 WavLM 音韻先驗錨定生成,主打降低 linguistic 與 acoustic hallucination。
- EfficientAD 輕量 student-teacher 加全域 autoencoder,MVTec Detection AUROC…
五篇速讀
AnyEnhance:具 Prompt 引導與 Self-Critic 的統一生成式語音增強
統一生成主力
為什麼重要:一把處理 denoising、dereverb、declip、超分與 target speaker extraction,speech 與 singing 共用,榜單訊號強。
帶走什麼:Masked generative + prompt in-context 參考音色;self-critic 迭代自评 refinement 拉高主觀與客觀品質。
下一步:先聽 demo、對 ALL-GSR 與 DNS with-reverb 指標;有 reference 時測 prompt 路徑。
PASE:運用 WavLM 音韻先驗的低幻覺生成式語音增強
低幻覺路線
為什麼重要:生成式 SE 聽感好但重噪易亂講話內容與說話人;PASE 把幻覺拆成 linguistic/acoustic 對症下藥。
帶走什麼:WavLM 經 representation distillation 成 denoising expert;vocoder 雙流分離語音內容與 speaker/prosody。
下一步:讀方法段對照 hallucination 定義;在 DNS 2020 with-reverb 聽內容是否跑題。
MaskSR:用於全頻帶語音修復的 Masked Language Model
全頻帶 MLM
為什麼重要:把 LM 式 masking 拉進 44.1 kHz 全頻帶 GSR,同時面對 noise、reverb、clipping、頻寬不足。
帶走什麼:以 neural codec 離散 token 訓練預測被 mask 的乾淨 token,推論用 iterative sampling 重建。
下一步:與 AnyEnhance/VoiceFixer 同台比 ALL-GSR;關注 full-band 聽感與 DNSMOS 系列。
VoiceFixer:以 Neural Vocoder 邁向通用語音修復
GSR 基準作
為什麼重要:定義一般語音修復 GSR,分析加合成兩段式,後續 ALL-GSR 榜多以其設定作比較底座。
帶走什麼:ResUNet 分析、neural vocoder 合成;同時對付加性噪、混響、低解析與 clipping,並可泛化到真實劣化錄音。
下一步:當歷史基線與資料設定來源;新模型數字先對齊其 ALL-GSR 協議再比。
EfficientAD:毫秒級延遲的精確視覺異常檢測
工業速度派
為什麼重要:唯一非語音篇;在真實產線要的是低錯誤率加極低延遲,不只刷 AUROC。
帶走什麼:輕量特徵擷取小於 1ms;student 只學 normal、loss 阻止模仿 abnormal;AE 補 logical anomaly。
下一步:看 MVTec 等 32 套件設定與 2ms/約 600 fps 宣稱;評估能否塞進既有 AOI 流程。