AI Radar Daily 2026-08-07
改用 open_page 抓 README 重點。--- title: "AI RADAR DAILY 2026-08-07 — Agent 基建與垂直應用爆發" date: 2026-08-07 status: pending_review tags: [AI, Agent, MCP, RAG, Automation, 開源工具] word_count: ~2850
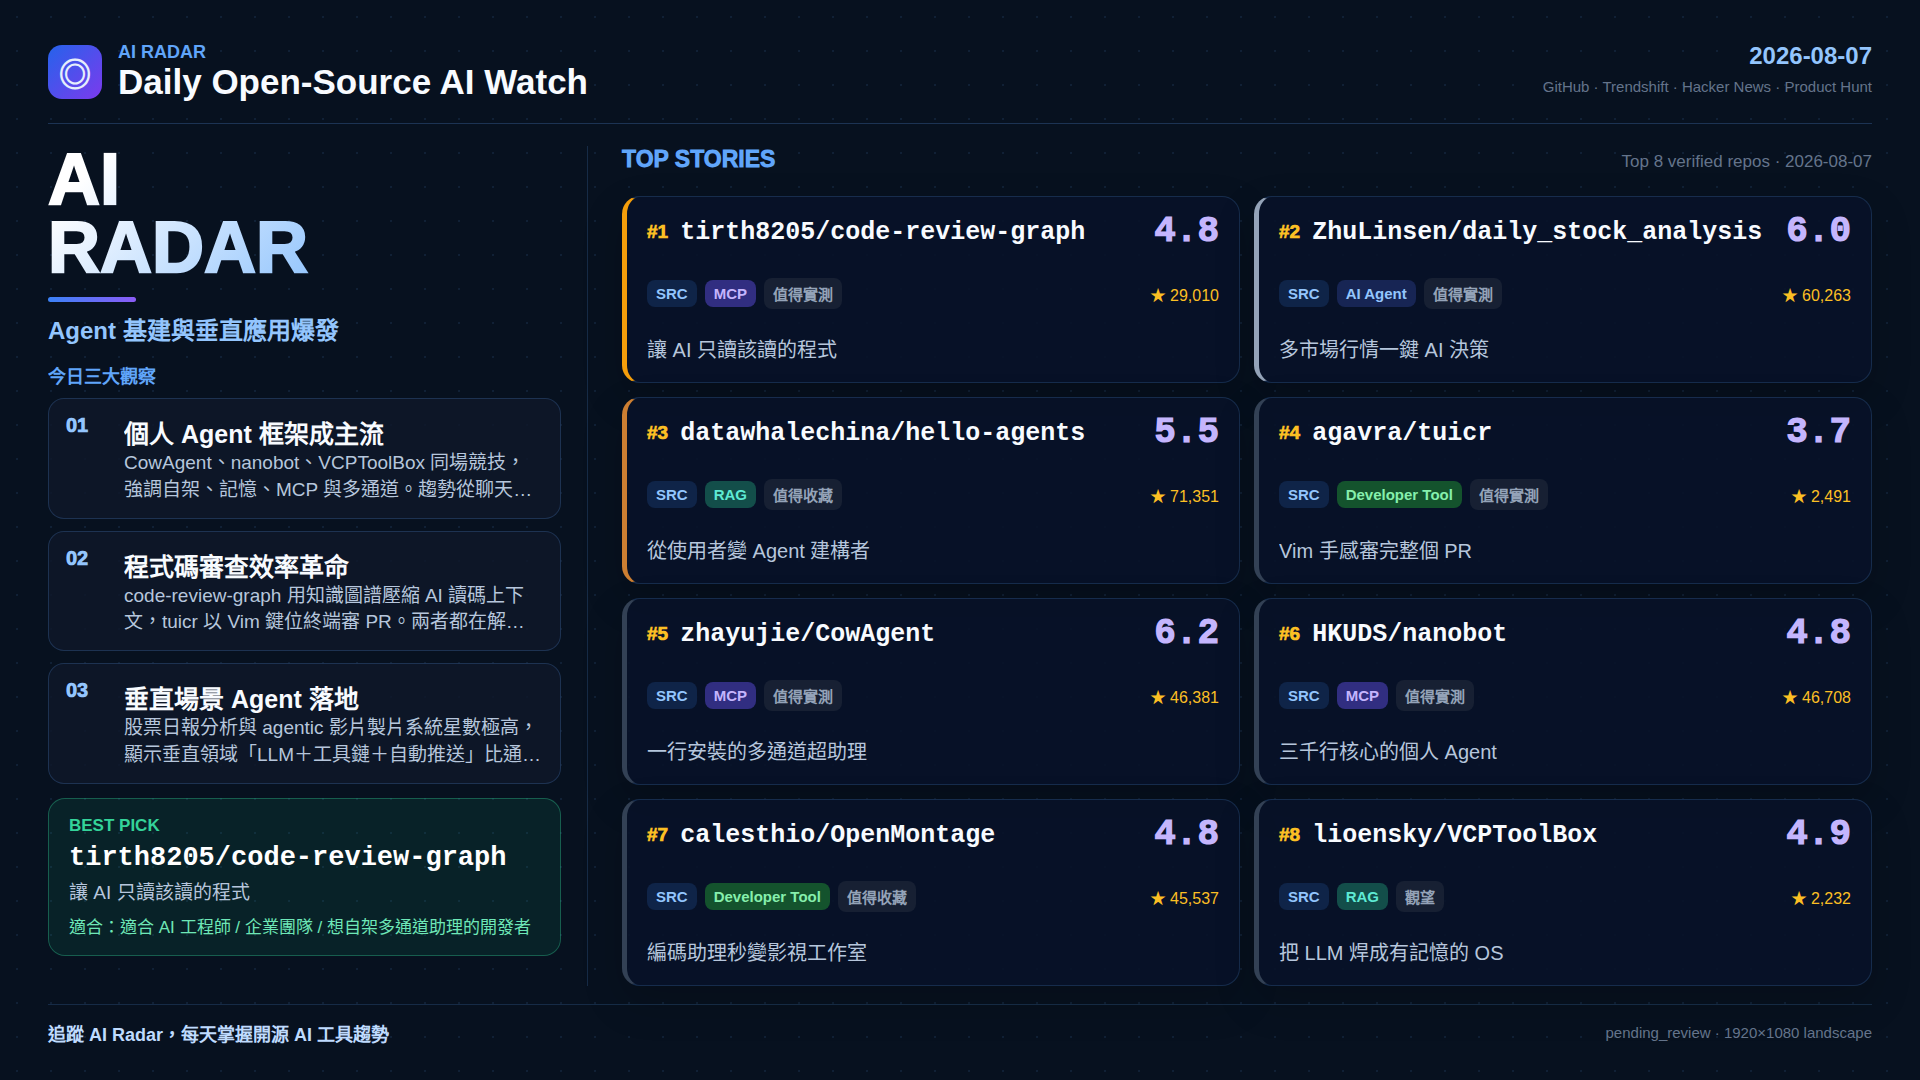
今天榜單最清楚的訊號不是「又多幾個聊天機器人」,而是 Agent 工程正在分層:底層是可自架、可記憶、可接 MCP 的 Agent Harness;中層是把上下文、審核、工具協議做對的開發者基建;上層則是股票日報、影片製片這類「LLM+工具鏈+自動推送」的垂直系統。CowAgent、nanobot、VCPToolBox 同場競技,說明個人助理已從對話介面升級為可規劃任務、可演化技能的運行時。與此同時,code-review-graph 用知識圖譜壓縮讀碼上下文,tuicr 用 Vim 鍵位終端審 PR,兩者都在打同一個痛點——AI 寫碼速度遠超人類審核帶寬。星數與討論熱度也顯示:能每天自動交付決策的垂直應用,比通用聊天更吸睛。以下依趨勢、工具與首選逐層拆解。
一、今天的趨勢
第一條主線是 Agent 基建同場競技,關鍵詞收斂在自架、記憶、MCP 與多通道。CowAgent 把自己定位成開源超級助理與 Agent Harness:任務規劃、工具與 Skills、長記憶與知識庫、多模型與多 IM 通道,並原生接 MCP。nanobot 走另一條路——超輕量、可讀核心、WebUI/終端/聊天 App 一體,強調自架個人 Agent 與 MCP、多 Agent 委派、排程自動化。VCPToolBox 則更像 API 與前端之間的中介層,用統一指令協議、多層持久化記憶、插件引擎與多 Agent 協作,把無狀態 LLM 包成可操作實體世界的系統。三者差異在厚度與哲學:有人要完整 Harness,有人要可讀 kernel,有人要 AGI OS 級中介;共同點是——聊天只是通道,規劃、記憶與工具才是產品。
第二條主線是 AI 寫碼後的人類審核瓶頸。模型能快速改倉庫,但審 PR 仍耗時、耗 token、易漏依賴。code-review-graph 用 Tree-sitter 建本地程式碼結構圖,增量追蹤變更,再透過 MCP/CLI 只餵相關上下文,直接砍掉「整庫重讀」。tuicr 則把審核體驗拉回終端:Vim 鍵位、GitHub 風格 diff、行級留言,並可把真正的 PR review 推回 GitHub,服務 human-in-the-loop。兩者一前一後——前者讓 AI 只讀該讀的,後者讓人更快批 AI 產物——合起來才是可規模化的寫碼閉環。
第三條主線是垂直領域「LLM+工具鏈+自動推送」碾壓通用聊天。daily_stock_analysis 把多市場行情、新聞、指標與 LLM 決策看板串成日報,並推到企業微信、飛書、Telegram 等;OpenMontage 把編碼助理變成 agentic 影片製片廠,用管線、工具與 skill/知識檔把製作流程工程化。這類專案星數極高,原因很務實:使用者要的是可重複的交付物與節奏,不是無限對話。通用 Agent 提供能力平面,垂直系統則把能力鎖進業務結果;今天榜單同時給兩邊投票,但眼球明顯偏向「每天自動交報告、交成片」的落地形態。
綜上,2026 年中的開源敘事已從「接一個 bot」變成「選一層基建、補一塊審核、再嵌一條垂直流水線」。MCP 成為工具互操作的預設接口;記憶與圖譜成為降 token、提精準的標配;而人類介面(TUI、看板、推送)決定 Agent 能否進入真實工作流。
二、Top 8 工具
#1 tirth8205/code-review-graph(Score: 4.8,MCP)
本地優先的程式碼智能圖譜,透過 MCP 與 CLI 向 AI 編碼工具提供精準上下文。以 Tree-sitter 解析結構、增量重建圖譜,讓審查與大型倉庫工作流不必整庫灌進上下文。支援一鍵 install 對接 Claude Code、Cursor、Codex、Gemini CLI 等多平台,定位清楚:不是又一個 chat wrapper,而是讀碼帶寬的壓縮器。評語:在「AI 寫得快、審得慢、token 燒得多」的交叉點上,這是少數把問題定義成可度量工程、並用本地圖譜落地的專案;今日首選亦落於此。
#2 ZhuLinsen/daily_stock_analysis(Score: 6.0,AI Agent)
LLM 驅動的多市場股票智能分析系統:多源行情、即時新聞、決策看板與多通道自動推送,支援定時、低成本運行。它把「蒐集—分析—產出—推送」收成一條可自架流水線,服務的是每天要看結論的人,而不是要一個能閒聊財經的 bot。評語:垂直應用教科書級範例——領域資料源+LLM 結構化輸出+推送通道;熱度高,正因為交付物是日報與決策板,價值可被日曆驗證。投資決策仍須自行判斷,工具只負責加速資訊整理。
#3 datawhalechina/hello-agents(Score: 5.5,RAG)
Datawhale 社群的《從零開始構建智能體》系統性中文教程與實作,覆蓋原理、實作路徑與社群共創專案,並提供 PDF 與站點資源。它不是單一 runtime,而是把 Agent 從概念拆到可練手的教材層。評語:當榜單上全是框架與產品時,系統性中文教程填補「能跑」與「懂為什麼這樣設計」之間的缺口;對想自建 Agent、而不是只會調 API 的學習者與團隊,這是長期資產型倉庫。
#4 agavra/tuicr(Score: 3.7,Developer Tool)
帶 Vim 鍵位的終端機程式碼審查 TUI:GitHub 風格 diff、行級留言,並可把審查結果以真正的 PR review 推回 GitHub;亦提供非 TUI 的 session/留言操作,方便腳本與 agent 銜接。評語:分數不高不代表不重要——它精準服務「AI 大量產 diff 之後,人類如何在終端高效把關」。鍵位與工作流貼近重度開發者,是 human-in-the-loop 審核體驗的補丁,與圖譜類上下文工具形成上下游。
#5 zhayujie/CowAgent(Score: 6.2,MCP)
開源超級 AI 助理與 Agent Harness(前身 chatgpt-on-wechat 一脈):任務規劃、三層記憶與 Deep Dream、知識庫與圖譜、Skills/工具、原生 MCP、多模型與 Web/微信/飛書/Telegram/Slack 等多通道,強調可演化與一行安裝。評語:榜單上「完整個人 Agent 產品形態」的代表——通道與記憶做滿,Harness 敘事清晰。適合要 24/7 自架助理、並願意在 Skills 與通道上經營工作流的使用者;體量與能力面較大,取捨是完整度優先於極簡核心。
#6 HKUDS/nanobot(Score: 4.8,MCP)
超輕量自架個人 AI Agent 框架(Python):WebUI、終端與聊天 App,內建工具、長期記憶、MCP、模型路由、多 Agent 委派、排程與 OpenAI 相容 API,核心可讀、部署路徑清楚。評語:與 CowAgent 對照鮮明——nanobot 更像 Agent kernel:小核心、可擴、研究友善。若你要的是可審查、可改、可當閘道長期跑的自架 runtime,而不是功能清單最長的一站式產品,nanobot 的哲學更對味。
#7 calesthio/OpenMontage(Score: 4.8,Developer Tool)
開源 agentic 影片製片系統:多條製作管線、大量工具與 agent skill/製片知識檔,把 Claude Code、Cursor 等編碼助理變成製片廠;強調品質閘門、審核軌跡與階段強制。評語:垂直應用的另一極——不是聊天生成一段片,而是把製片當工程做。高星數反映「可交付成片」的吸引力;門檻在管線理解與環境配置,回報是內容生產自動化的可複用骨架。
#8 lioensky/VCPToolBox(Score: 4.9,RAG)
部署在模型 API 與前端之間的 AGI OS 級 Agent 基建中介層:統一指令協議、多層持久化記憶、分散式插件引擎與多 Agent 協作,目標是把無狀態 LLM 改造成具持久自我、工具操作與群體協作能力的完整智能體系統。評語:野心最大、抽象層最高——賣的不是單一助理,而是「中介作業系統」。適合要深度客製協議與插件生態的建構者;相對地,學習曲線與架構負擔也高於開箱即用的 CowAgent/nanobot。
三、今日首選
tirth8205/code-review-graph
選它當 Best Pick,不是因為星數壓過股票或助理類專案,而是因為它打在 Agent 寫碼浪潮裡最硬、也最被低估的約束:上下文經濟學與審查可信度。AI 編碼工具的預設行為很容易變成「多讀一點比較安心」,於是 token、延遲與噪音一起上升,審查品質反而下降。code-review-graph 的回答很工程:本地建持久結構圖,檔案變更自動/增量更新,再經 MCP 與 CLI 只暴露相關子圖與符號關係,讓模型「只讀該讀的程式」。
這與單純 RAG 貼檔不同。圖譜編碼的是定義、引用、模組邊界與變更影響面,更贴近 code review 真正需要的問題——這次 diff 碰了誰、風險在哪、該打開哪些相鄰檔。專案提供跨 Copilot、Cursor、Claude Code、Codex 等平台的 install 路徑,說明作者把「接進現有 AI 編碼日常」當一等需求,而不是另起一套聊天 UI。對大型倉庫與反覆審查場景,這種本地優先、可基準測量的上下文壓縮,比再包一層 prompt 更有複利。
把它與 tuicr 並讀更有意思:圖譜降低 AI 側誤讀與過讀,TUI 提高人類側批改吞吐——首選前者,是因為上下文一旦失控,後面所有 Agent 技能與垂直流水線都會變貴且不穩。若你的團隊已經讓模型寫 PR,卻仍在為審查成本與幻覺依賴买单,code-review-graph 值得今天就試裝;它不取代人,只讓人與模型都少做無效閱讀。
四、評分方式說明
AI Radar 分數綜合開源熱度(星數成長與討論)、工程完整度(文檔、可安裝性、協議支援如 MCP)、問題定義清晰度,以及是否指向可複用的工作流而非一次性 demo。垂直應用會額外權衡「自動交付物」是否明確(日報、成片、審查輸出);基建類則權衡自架成本、記憶/工具擴展與互操作性。分數用於當日相對排序與編輯選題,不代表長期投資建議,亦不等同生產環境安全認證。讀者應以自身資料敏感度、授權條款與維運能力做最終取捨;本刊評析僅供技術觀測。
若你正在從「會聊天的 bot」迁到「能進工作流的 Agent」,今天可以依序做三件事:用 code-review-graph 卡住讀碼上下文、在 CowAgent 與 nanobot 之間選一套符合你對完整度/内核哲學的自架 Harness,再挑一條垂直流水線(日報或製片)驗證「工具鏈+推送」是否真能每天交件。歡迎把你的自架組合與踩坑回饋到 AI Radar,我們會持續追蹤 Agent 基建與垂直應用的下一次分層。