AI Radar Daily 2026-08-10
改用開啟頁面取得各 repo 重點。資料已齊,開始依結構與字數要求完稿。
title: "AI RADAR DAILY 2026-08-10 — Agent技能、省Token與安全" date: 2026-08-10 status: pending_review tags: [AI, Agent, MCP, RAG, Automation, 開源工具] word_count: ~2450
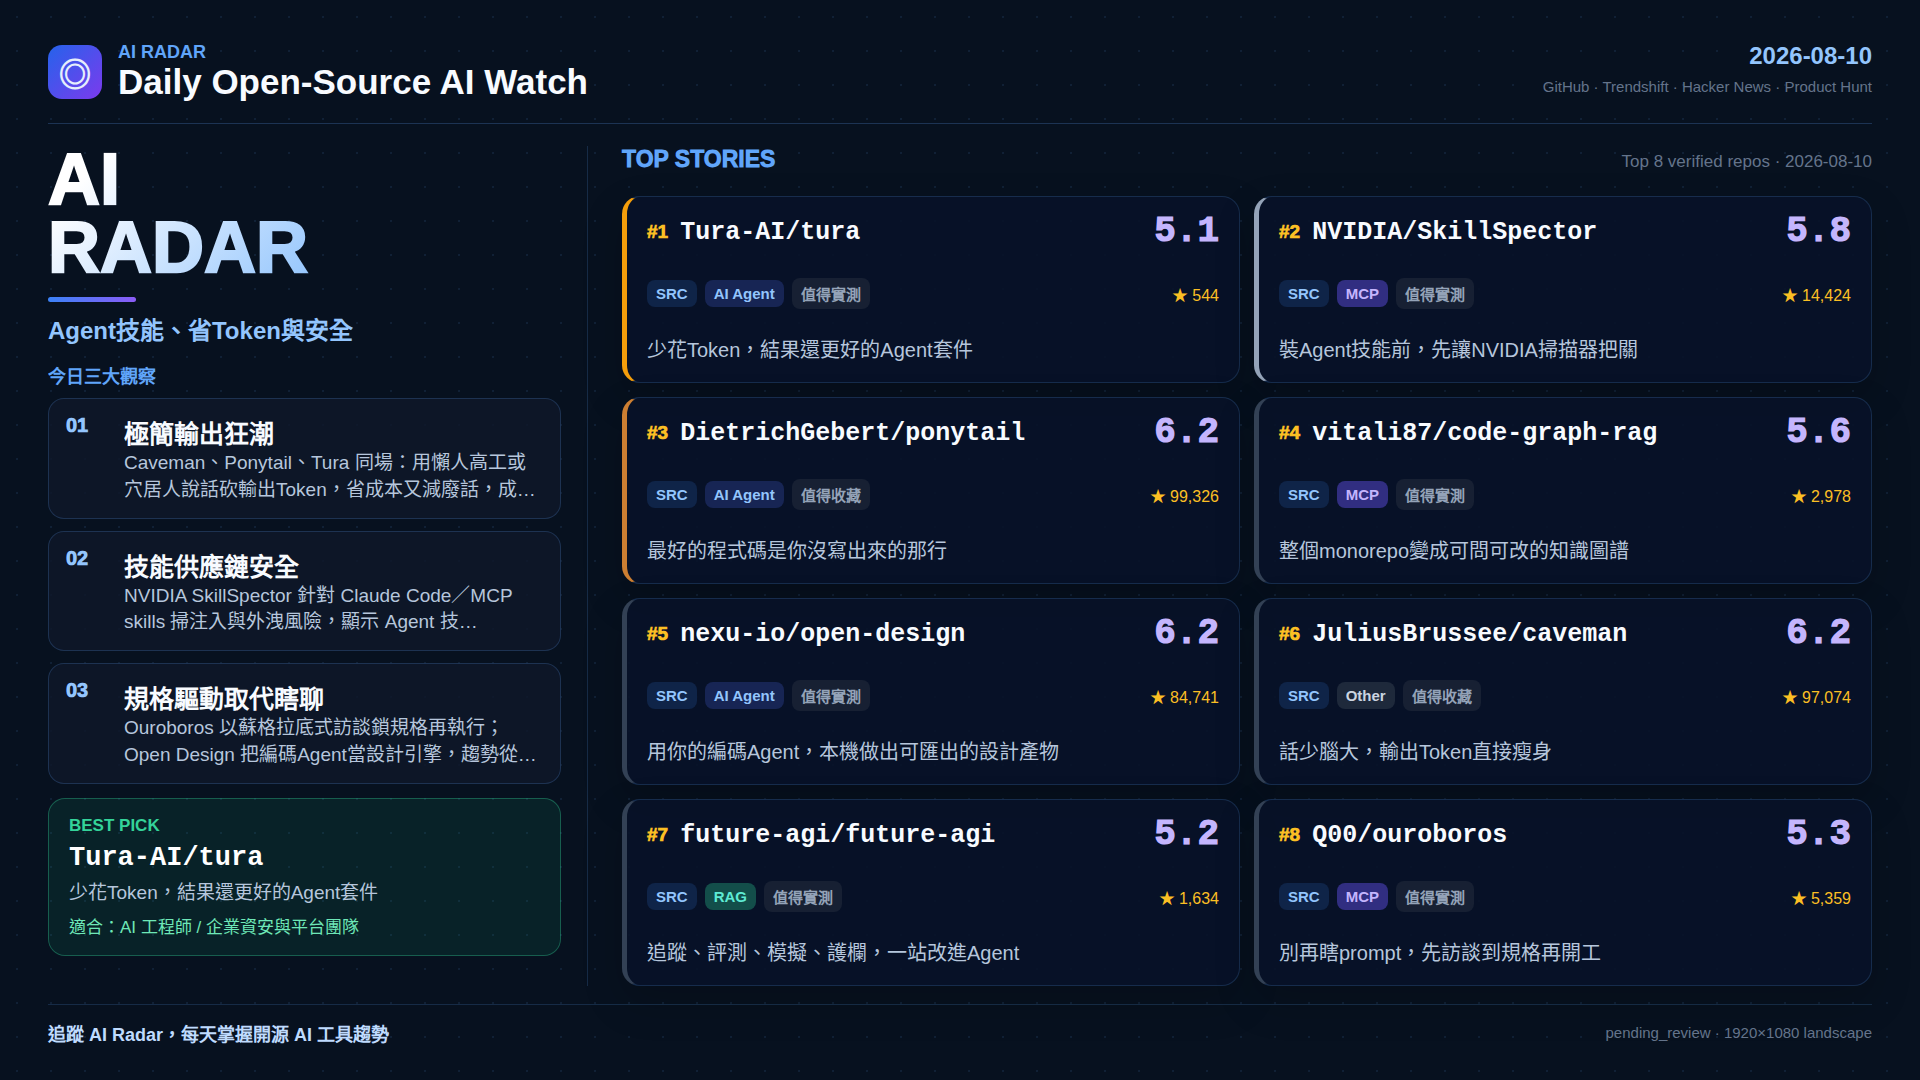
今天的 Agent 生態,真正在搶注意力的不再是「又能多寫幾行 code」,而是三件事同時落地:怎麼用更少 Token 跑完長程任務、怎麼在安裝技能前先掃風險、以及怎麼把隨口 prompt 收成可重播的工作流。Caveman、Ponytail 與 Tura 同場證明,省輸出與省往返並不是小技巧,而是可量化的成本與成功率槓桿;NVIDIA SkillSpector 則把技能安全從事後補洞,推到「安裝前必掃」。另一方面,Ouroboros 用蘇格拉底式訪談先鎖規格,Open Design 把既有編碼 Agent 當設計引擎,顯示產業正在從聊天式下指令,轉向可觀測、可重跑的流程層。今日榜單幾乎都圍著 Agent 技能、省 Token 與安全這三條軸轉,值得當成一週的操作方向來讀。
一、今天的趨勢
第一條熱敘事是「懶人高工/穴居人說話」這類溝通與生成約束。Caveman 強迫 Agent 用極短句輸出,散文場景可砍約六成五輸出 Token,長程 coding run 仍有約一成內的節省,重點是技術內容不縮水、程式與錯誤訊息保持精確。Ponytail 則從另一端下手:讓 Agent 像最懶的資深工程師,先問任務是否該存在,再選標準庫與最短可動方案,避免過度工程。Tura 走 runtime 層,用巨觀指令、反向推理與任務狀態管理,減少模型往返與重複上下文;公開基準上可同時出現「Token 大幅下降」與「成功率上升」兩種配置。三者合起來說明:省 Token 已從提示詞小抄,升級成技能、persona 與 harness 的產品化路線。
第二條是 Agent 技能安全進入「安裝前必掃」。技能與 MCP 擴充讓 Agent 能力暴增,也讓注入、外洩、供應鏈與工具投毒變成常態風險。NVIDIA 開源的 SkillSpector 針對 Claude Code、Codex、MCP skills 等做靜態與可選語意掃描,涵蓋數十種漏洞模式與風險評分,並可作為 MCP server 嵌進既有 Agent。這標誌技能生態已從「下載就用」進入與軟體依賴掃描類似的治理階段:未掃先裝,等於把高權限執行權交給未審內容。
第三條是規格鎖定與可重播工作流。Ouroboros 先以蘇格拉底訪談挖出隱藏假設,再驅動多運行時 Agent 執行;Open Design 則以在地優先工作區,把你已有的編碼 Agent CLI 當設計引擎,用結構化技能與設計系統產出原型、簡報與介面。趨勢很清楚:隨口一句 prompt 無法撐住長任務與跨工具協作,產業開始要求可重播、可觀測、可約束政策的流程層,而不是單次對話運氣。
二、Top 8 工具
#1 Tura-AI/tura(Score: 5.1,AI Agent)
開源 Agent runtime harness,定位是長程 repo 工作:用明確執行狀態、較少模型往返與可稽核流程,換取更好結果與更低 Token。公開敘述在 DeepSWE 類任務上,Direct 配置相對 Codex CLI 可減少約七成七聚合 Token、成功率相當;Balanced 則把省下的預算回填推理與驗證,成功率可高約十六點七個百分點,同時仍少用約三成 Token。核心手段包括巨觀 `command_run`(一次打包多步 shell/patch/測試)、反向推理引導,以及把 context 當 runtime 狀態機管理,而不是無限制堆技能與歷史。適合把「省錢」和「提高通過率」一起當 KPI 的團隊。評語:今日最完整的 harness 級答案,不只教 Agent 少說話,而是少繞圈、少丟狀態。
#2 NVIDIA/SkillSpector(Score: 5.8,MCP)
安裝前掃描 AI Agent 技能的安全工具,覆蓋 prompt injection、資料外洩、權限提升、供應鏈、過度代理、系統提示外洩、記憶投毒、MCP tool poisoning 等約十七類、六十餘種模式;支援 repo、URL、zip 與單檔,輸出終端機、JSON、Markdown、SARIF,並可跑 MCP server 供 Claude Code 等呼叫。研究面提到技能中有相當比例帶漏洞或疑似惡意意圖,SkillSpector 也銜接 NVIDIA Verified Skills 管線(掃描、簽署、skill card)。評語:技能市場若要規模化,這類閘道會從可選變成預設;現在接入 CI 與安裝腳本,成本遠低於事後清災。
#3 DietrichGebert/ponytail(Score: 6.2,AI Agent)
讓 Agent 以「最懶資深工程師」決策:懶是效率不是草率——先 YAGNI、先標準庫、先一行頂五十行,但不砍驗證、錯誤處理與安全。以 skill/plugin 形式支援多款 Agent,核心是寫 code 前的決策階梯,目標減少過度工程與無用抽象。社群討論常把它對標「Agent 最愛寫太多」的痛點,並強調可觀測的精簡幅度。評語:和 Caveman 互補——一個砍嘴砲 Token,一個砍多餘程式與設計;長任務裡兩者疊加,維護成本與上下文膨脹會明顯下降。
#4 vitali87/code-graph-rag(Score: 5.6,MCP)
面向 monorepo 的程式碼 RAG:以 Tree-sitter 等解析多語言程式庫,在圖資料庫(如 Memgraph)建立結構知識圖譜,再用自然語言查詢、理解與編輯程式。重點是跨語言統一 schema,以及模組、函式、類別與 import 邊等可遍歷關係,比純向量切片更適合回答「誰呼叫誰、影響範圍在哪」。近期還以可插拔方式擴語言支援。評語:Agent 若只靠全文搜尋,長 repo 容易漏依賴;圖譜 RAG 是把「結構」還給檢索層的務實路線,適合當 MCP 能力掛進編碼 Agent。
#5 nexu-io/open-design(Score: 6.2,AI Agent)
開源、在地優先的 Claude Design 替代工作區:自動偵測本機編碼 Agent CLI(Claude Code、Codex、Cursor、Gemini 等),以可組合 Skills 與設計系統驅動原型、儀表板、簡報、行動介面乃至動態畫面。強調結構化探索(方向選擇、待辦進度、沙箱預覽、多格式匯出),而不是單次靈感 prompt。評語:把「設計」從獨立封閉產品,拆成「既有 Agent + 可重播技能棧」,符合今日從隨口指令走向工作流的大方向,也降低被單一雲端設計產品綁定的風險。
#6 JuliusBrussee/caveman(Score: 6.2,Other)
技能/外掛:逼 Agent 用穴居人短句溝通,散文輸出可減約 65% Token,長程 agentic coding 實測約 8.5%;程式、指令與錯誤保持 byte-level 精確。支援 Claude Code、Codex、Gemini、Cursor 等三十餘種環境,並提供多強度等級。本質是縮小「嘴」而非縮小「腦」——同一修復,字數砍到約三分之一。評語:安裝成本低、節省立即反映在帳單上,是今日省 Token 敘事裡傳播最廣的入口技能;正式文件與對外溝通場景記得切回正常語體即可。
#7 future-agi/future-agi(Score: 5.2,RAG)
開源、可自架的 LLM/Agent 評測、觀測與改進平台:涵蓋評估、追蹤、模擬、護欄、閘道與優化,強調從原型到上線同一回饋迴路。對 Agent 特別有意義的是軌跡級與多輪評測,而不只看最終一段文字。評語:榜上工具愈多,愈需要可重複的評測底座;沒有 eval 與 trace,省 Token 與加技能都只是感覺良好。適合把「改 prompt/加 skill」變成有數字的迭代。
#8 Q00/ouroboros(Score: 5.3,MCP)
Agent OS 取向:先停手寫模糊 prompt,改以蘇格拉底訪談暴露隱藏假設,結晶成規格(seed)後再交多運行時 Agent 執行;強調可重播、可觀測、政策邊界。訪談代理只提問不實作,與後續架構/執行角色分離。評語:直接對準「返工來自規格沒鎖死」;和 Open Design、Tura 同一條產業曲線——把非確定性聊天,收斂成可治理的工作流。適合需求易飄、多人或多工具協作的專案起手式。
三、今日首選
Best Pick:Tura-AI/tura
選 Tura 而非單純爆紅的說話技能,是因為它處理的是 Agent 成本結構的根因:長程任務裡,Token 大戶往往不是最後那一段總結,而是反覆的小工具往返、重複塞進上下文的技能與歷史,以及壓縮後遺失執行細節導致的重新摸索。Tura 以 runtime harness 切入,把多步 shell、patch、建置與測試收成巨觀執行樹,讓模型少開幾輪對話;用反向推理降低「統計上常見但平庸」的實作路徑;再用任務狀態、runtime prompt 與可保留檢查點的壓縮,讓 context 跟著任務機走,而不是無限累積。
公開基準敘事同時給出兩種花錢方式:Direct 把優勢換成帳單下降(約 77.5% 較少聚合 Token,成功率與對照相當);Balanced 把省下的預算餵回推理與驗證,成功率明顯更高卻仍少用約三成 Token。這種「可選配置」比單一省話術更接近工程現實——有人要控成本,有人要過 verifier。它也補上 Caveman/Ponytail 蓋不住的層:後兩者優化表達與產出形態,Tura 優化執行圖與狀態;三者並用時,口頭廢話、多餘程式與無效往返可以一起被壓縮。
當然需保持審慎:基準任務集與對照配置有範圍,跨模型、跨 OS 與更多提供商的等價性仍在路線圖與已知缺口中。但就「今日最熱敘事=省 Token 又要結果」而言,Tura 是少數用 harness 級機制把故事說圓、並附可稽核產物方向的開源選項。若你本週只打算認真試一個後端,優先跑 Tura 的長任務對照,再決定要不要疊 Caveman 與 Ponytail。
四、評分方式說明
AI Radar 分數用於當日相對排序,不是絕對星等,也不是投資建議。綜合維度大致包括:與當日主題(Agent 技能、省 Token、安全、可重播工作流)的契合度、問題定義是否清晰、開源可驗證程度、技術完整度(文件、基準、可安裝性)、生態位置(MCP/技能/runtime)以及討論熱度與可操作性。分數接近只代表同日比較下各有千秋;選型仍應以自身堆疊、權限模型與評測數據為準。榜上「Score」僅作編輯排序參考,閱讀時請搭配用途與風險自行權衡。
若你正在組 Agent 工具鏈,建議本週固定三件事:安裝前用 SkillSpector(或同等掃描)閘技能;長任務用 harness/工作流鎖狀態與規格;輸出與實作層再疊省 Token 技能。歡迎把你的對照數據與失敗案例丟回 AI Radar,我們會持續追蹤可重現的結果,而非只追星數。