AI Radar Daily 2026-08-12
先查這幾個熱門 repo 的實際定位與近期動態,再寫成符合字數與結構的深度分析。--- title: "AI RADAR DAILY 2026-08-12 — AI代理與本地記憶基建爆發" date: 2026-08-12 status: pending_review tags: [AI, Agent, MCP, RAG, Automation, 開源工具] word_count: ~2850
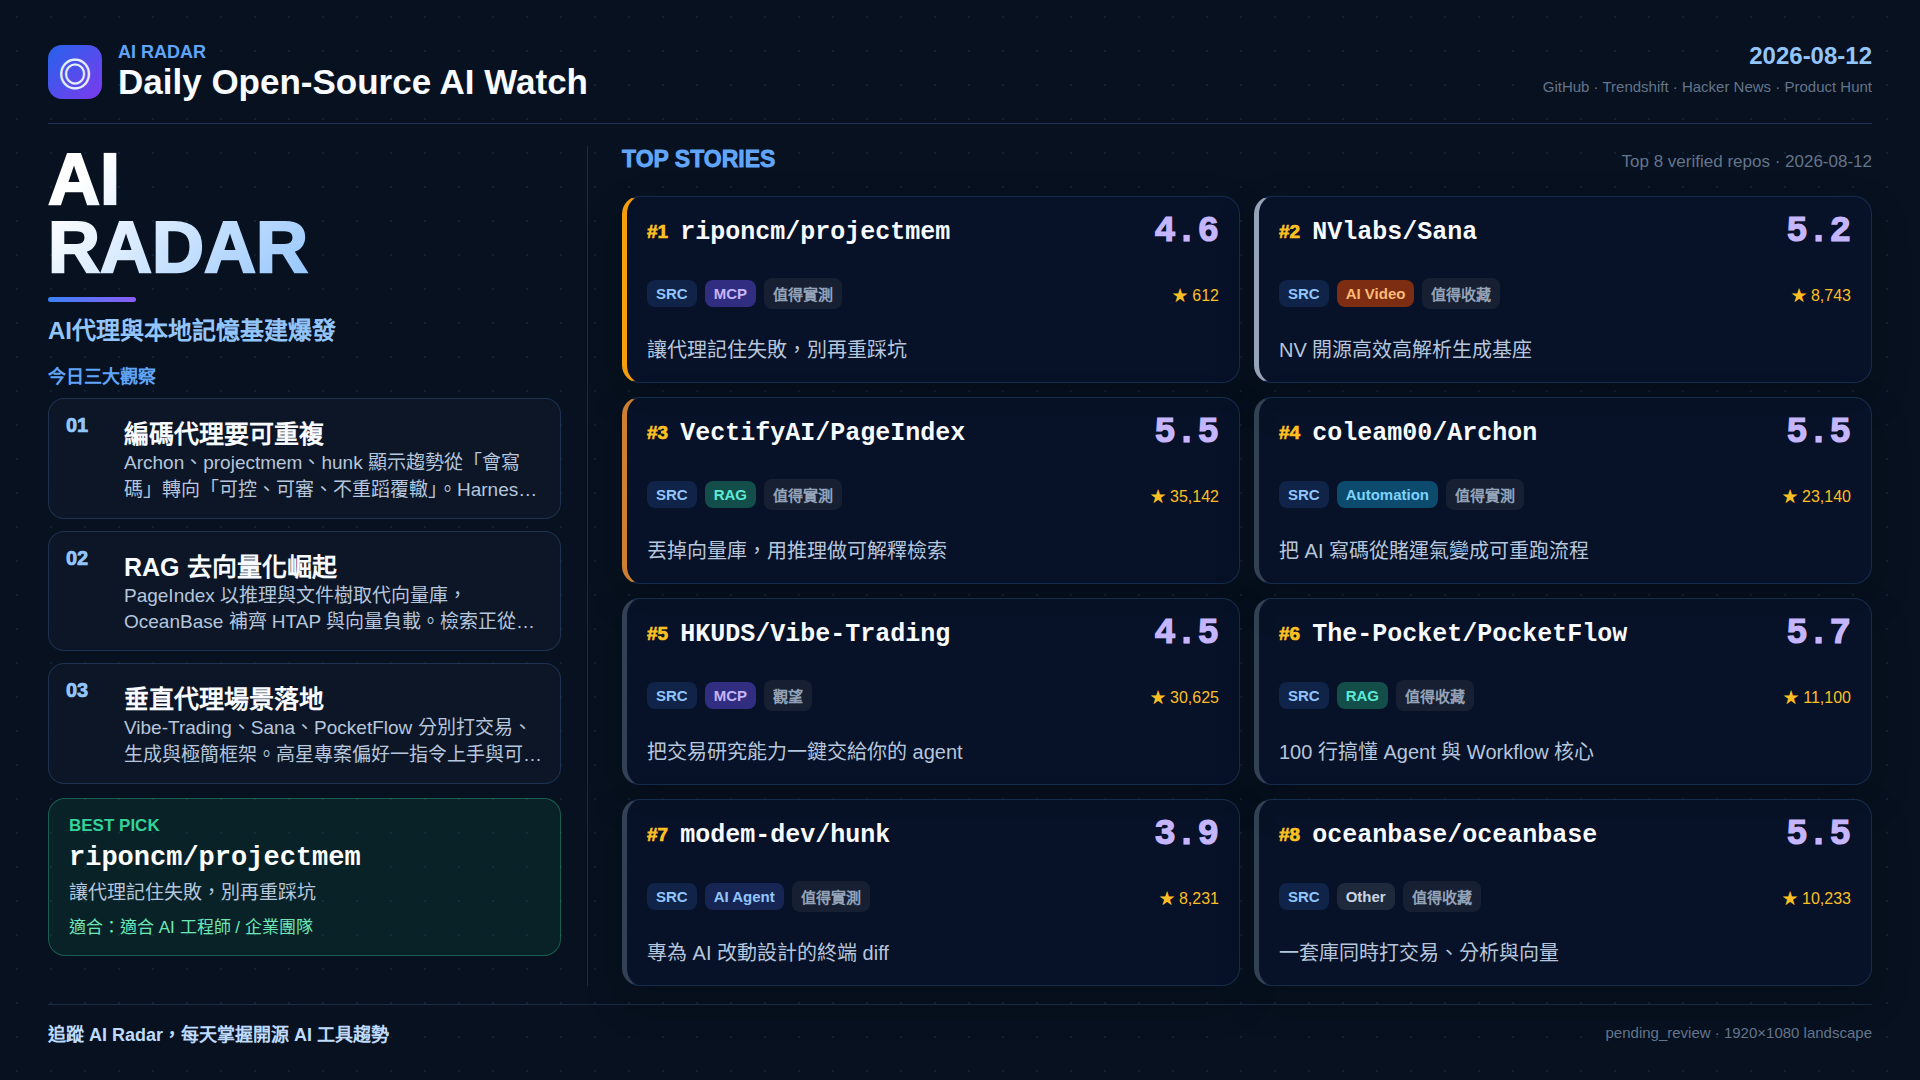
今天盤點最清楚的訊號不是又一個「會寫程式的模型」,而是一整層正在成形的代理工程基建:本地記憶、可重複 harness、面向代理變更的審核介面,以及不再預設向量相似度的檢索路徑。過去一年產業習慣用「能生成多少程式碼」衡量進步;到了 2026 年中,真正拉開差距的是:代理犯錯後會不會留下可查的紀錄、下一次會不會避開同一條失敗路徑、人類能否在終端機裡用可讀的 diff 與 provenance 把關。Archon、projectmem、hunk 這三條線同時抬升,說明社群已從「讓代理更敢改」轉向「讓代理改得可控、可審、不重蹈覆轍」。並行發生的是檢索範式鬆動——PageIndex 用文件樹與推理搜尋挑戰 chunk-embed-retrieve 預設,OceanBase 把 HTAP 與向量負載收進同一引擎;應用層則有 Vibe-Trading、Sana、PocketFlow 分別用一指令上手、高效生成與極簡可組合框架搶佔心智。今日整體趨勢可濃縮為一句話:AI 代理與本地記憶基建正在爆發,Harness 與記憶層成為代理工程的核心層。
一、今天的趨勢
第一條洞察圍繞「可控、可審、不重蹈覆轍」。編碼代理的瓶頸已從「會不會寫」變成「會不會重犯」。同一個專案裡,代理常在相隔數小時後重試已被否決的修法、動到已知脆弱檔案,或把臨時 workaround 當成新發現。projectmem 把 issue、attempt、fix、decision 落成 append-only 事件日誌,再透過 MCP 把濃縮判斷餵回代理,並在動作前做決定性閘門;Archon 則把規劃、實作、驗證、review、開 PR 收成可版本控管的 YAML workflow,讓流程可跨專案重複執行;hunk 專攻代理產出的 changeset,在終端機提供 review-first 的 diff 體驗,並讓代理註解與 hunk 並排。三者合在一起,標示 harness 與本地記憶不再是外掛小工具,而是代理工程的基礎設施層:記憶負責「記得失敗」,harness 負責「重複做對的流程」,審核介面負責「人類仍握有最後一哩可見性」。
第二條洞察是檢索正從「相似度」轉向「可解釋的推理路徑」。向量庫與 embedding 仍重要,但長文件、強結構文件(財報、規格、法規)上,純 top-k 相似常給出看似相關、路徑卻不可追溯的片段。PageIndex 選擇不做向量庫、不強制 chunk,先建階層文件樹,再讓模型在樹上做類似目錄導覽的推理檢索,目標是 traceable、explainable、context-aware。另一端,OceanBase 以分散式資料庫姿態同時承接交易、分析與 AI 負載,原生向量與混合檢索補的是「資料仍在系統內、查詢不必為了 RAG 再複製一份」的工程現實。兩邊並非互相取代,而是提醒產業:RAG 的勝負關鍵逐漸從「embedding 分數」移到「路徑是否可解釋、負載是否可統一」。
第三條洞察落在應用與框架偏好:高星專案明顯偏好「一指令上手」與「可組合工作流」。Vibe-Trading 用 MCP 把完整交易研究能力掛到既有代理客戶端;Sana 以線性 Diffusion Transformer 壓低高解析影像與影片合成成本;PocketFlow 用約百行核心證明 agent、workflow、RAG 可以極簡表達,甚至讓代理幫人組代理。這不是單純的產品美學,而是代理時代的介面哲學——人類與上層代理都沒有耐心啃重型框架;能被一行指令啟動、能被小而清晰的抽象組合的東西,才容易進入真實工作流。今日榜單因此呈現清晰分工:記憶與 harness 管治理,推理式索引與 HTAP 管檢索與資料底座,垂直 MCP 與極簡框架管落地速度。
二、Top 8 工具
#1 riponcm/projectmem(Score: 4.6,MCP)
本地優先的 AI 編碼記憶層,定位是坐在各類編碼代理之上的 memory + judgment layer。它把開發過程中的問題、嘗試、修復與決策寫成事件,投影成代理可讀摘要,並透過 MCP 注入上下文;更關鍵的是 pre-action gate,能在代理重走失敗修法或改動已知脆弱檔案前發出警告。資料落在專案內 `.projectmem/` 與本機,無雲端、無遙測,也兼具 provenance 軌跡。評語:這是把「記憶」從聊天摘要升級成「治理」的代表作,直接對準代理最昂貴的浪費——重複犯錯與 token 空轉。今日 Best Pick,詳見下節。
#2 NVlabs/Sana(Score: 5.2,AI Video)
NVIDIA 實驗室開源的高效高解析影像(並延伸至影片)合成系列,核心是 Linear Diffusion Transformer:以線性注意力把複雜度從二次降到近似線性,搭配高壓縮 autoencoder 與 Mix-FFN 等設計,讓 4K 級生成在延遲與品質之間更可落地。相對於堆參數量硬上解析度,Sana 走的是架構效率路線,對需要在有限算力下做高解析內容管線的團隊更務實。評語:生成賽道仍熱鬧,但「能跑且跑得起」才是工程選型標準;Sana 把效率寫進模型結構本身,而不是只寫在 benchmark 標題。
#3 VectifyAI/PageIndex(Score: 5.5,RAG)
無向量資料庫的推理式 RAG 文件索引引擎。流程大致是:從長文件建立階層樹狀索引(近似語義目錄),再以 LLM 在樹上做 agentic、context-aware 的檢索,強調可追溯與可解釋,而非 embedding 近鄰。社群討論常把它放在「是否取代向量 RAG」的對立面;更精準的讀法是:它在單文件、強結構、需要引用路徑的場景特別有說服力,並把檢索問題從「像不像」改寫成「該往哪一節推理」。評語:2026 年 RAG 話語權正在分散,PageIndex 代表「推理路徑優先」這一極,值得與傳統向量管線並排評估,而不是二選一口號。
#4 coleam00/Archon(Score: 5.5,Automation)
開源 AI 編碼 harness 建構器,目標是讓代理開發流程可確定、可重複。開發者以 YAML 定義規劃、實作、驗證、code review、PR 等步驟,把「有時很神、有時很隨機」的代理使用方式,收斂成可跨專案重跑的 workflow engine。路線也從早期敘事收斂到 harness engineering:重點不是再包一層會寫碼的 agent,而是給既有編碼代理一套可監控、可編排的安全帶。評語:當團隊開始把代理寫進正式 SDLC,缺的往往不是更強的單次生成,而是可審查的流程骨架;Archon 踩在這個缺口上。
#5 HKUDS/Vibe-Trading(Score: 4.5,MCP)
「一指令」賦予代理完整交易分析與研究能力的專案,透過大量 MCP 工具把行情、研究、量化函式、審計與多資料源能力暴露給 Claude Code、Codex 等 MCP 客戶端,亦可 CLI / Web / API 使用。近期迭代強調身份閘門修正、quantlib 只讀呼叫、估值引擎缺欄位即不可跑、以及 hash 串接的稽核帳本,顯示作者群把「能喊單」與「能交代依據」綁在同一產品敘事裡。評語:垂直 MCP 的正確打開方式不是堆工具數量,而是把領域正確性與治理預設進協議;Vibe-Trading 在金融場景把這點做得相當完整,惟交易相關能力仍須人類風控與合規邊界,工具本身不替代決策責任。
#6 The-Pocket/PocketFlow(Score: 5.7,RAG)
約百行的極簡 LLM 框架,零依賴、無廠商鎖定,用小型圖抽象表達 Agent、Multi-Agent、Workflow、RAG 等模式,並明確鼓勵「讓代理也能組代理」的 agentic coding。它的對立面是日漸臃腫的全功能編排框架:功能齊全,卻讓人與編碼助手都難快速理解核心。PocketFlow 用可讀完的核心代碼換取可組合性與可教導性。評語:高分不完全來自「功能最多」,而來自「抽象夠小、心智負擔夠低」;在代理協助開發的時代,框架本身是否對代理友善,已是一等公民需求。
#7 modem-dev/hunk(Score: 3.9,AI Agent)
面向代理變更的終端機優先 diff 審核工具,review-first,建立在 OpenTUI 與 Pierre diffs 之上,指令風格貼近 Git,但打開的是適合逐 hunk 審視的 UI。亮點之一是代理可在 sidecar 留下摘要與理由,hunk 將註解渲染在對應變更上方,讓「模型為什麼這樣改」與「改了什麼」同一視線完成。評語:代理產生的 diff 量級與人類手寫不同,傳統 `git diff` 閱讀體驗正在成為瓶頸;hunk 分數雖非榜首,方向卻極關鍵——沒有好的審核介面,再強的 harness 與記憶也難閉環。
#8 oceanbase/oceanbase(Score: 5.5,Other)
面向交易、分析與 AI 負載的分散式資料庫,開源定位強調 HTAP 與向量等能力整合:同一引擎承接 OLTP、即時分析,並提供向量與全文等混合檢索,減少「業務庫 + 分析庫 + 向量庫」多套同步的成本與延遲。對 AI 應用而言,意義在於 context 所依的資料可以更新得更快、查詢計畫更統一,而不是每個 RAG demo 外掛一座專用向量服務。評語:基礎軟體很少成為日常明星,但當代理開始大規模讀寫企業資料,資料底座是否原生支援混合負載,會決定檢索架構能簡單到什麼程度。
三、今日首選
riponcm/projectmem 成為今日 Best Pick,不是因為星數或話題最大,而是因為它精準切中代理工程當下最痛、卻最常被「多開一個 chat」掩蓋的問題:失敗沒有被系統性記住,於是系統性重演。
多數編碼代理的「記憶」仍停留在對話窗、編輯器索引或臨時摘要。換 session、換模型、換人接手後,上週驗證失敗的 dependency 升級路徑、會弄壞 migration 的檔案、已被否決的 API 設計,都可能被當成全新探索再走一遍。代價是雙重的:token 與時間浪費,以及倉庫被反覆無意義攪動。projectmem 的回答很工程化——用 append-only、純文字、可確定性重放的事件日誌記錄 typed events(issues、attempts、fixes、decisions、notes),再投影成精簡、AI 可讀的摘要,經 MCP 提供給代理;同時以決定性 pre-action gate 在「重複失敗修法」與「觸碰脆弱檔案」前介入。論文與專案敘事把這稱為 Memory-as-Governance:記憶不只回答問題,還作用於下一步動作。
本地優先同樣關鍵。記憶寫在 repo 與本機目錄,離線可跑、無強制帳號與遙測,日誌本身又是可稽核的 provenance。對在意資料駐留與可重現 AI 協助開發的團隊,這比「雲端自動幫你總結」更對症。實務上它也不聲稱取代測試、CI 或 code review,而是補上長期缺失的一層:專案級失敗知識的結構化沉澱。與 Archon 的流程 harness、hunk 的變更審核並看,projectmem 負責的是時間軸上的教訓閉環——讓代理的昨天約束代理的今天。
選它做首選,是因為榜單上其他專案多半在「加強能力」或「降低使用門檻」,而 projectmem 在「減少重複傷害」。代理越強、改動越快,這類治理型記憶的邊際價值越高。若你只準備今天試一個倉庫,優先 `projectmem`:先讓失敗變得昂貴且可查,再談讓代理更大膽。
四、評分方式說明
AI Radar 分數綜合開源活躍度、技術完整度、可組合性(含 MCP / 代理友善程度)、問題切中度與短期工程落地價值,並依當日主題權重微調,而非單一 star 排行。分數反映的是「今日觀測視角下的相對強度」,用於編輯排序與閱讀導航,不構成投資、採購或安全性背書。同一 repo 在不同日期可能因趨勢切角變化而分數浮動;選型仍應以授權條款、維護狀態、威脅模型與自身場景驗證為準。榜單收錄開源工具與基礎專案,評語為編輯觀點,獨立於任何廠商置入。
結語與 CTA
代理時代的競爭,正在從模型對話品質,下沉到記憶、harness、審核與檢索路徑是否經得起真實專案的重複折磨。若本文的觀察對你有用,歡迎在內部工程頻道轉傳、回報你實際接入 projectmem / Archon / PageIndex 的經驗,或提交明日想看到深挖的 repo。AI Radar 持續以繁體中文記錄開源前線——把可驗證的訊號留下,把噪音濾掉。