AI Radar Daily 2026-08-16
先查幾個主要 repo 的公開資訊,讓文章評述更貼近實際專案。--- title: "AI RADAR DAILY 2026-08-16 — AI Agent全面落地潮" date: 2026-08-16 status: pending_review tags: [AI, Agent, MCP, RAG, Automation, 開源工具] word_count: ~2450
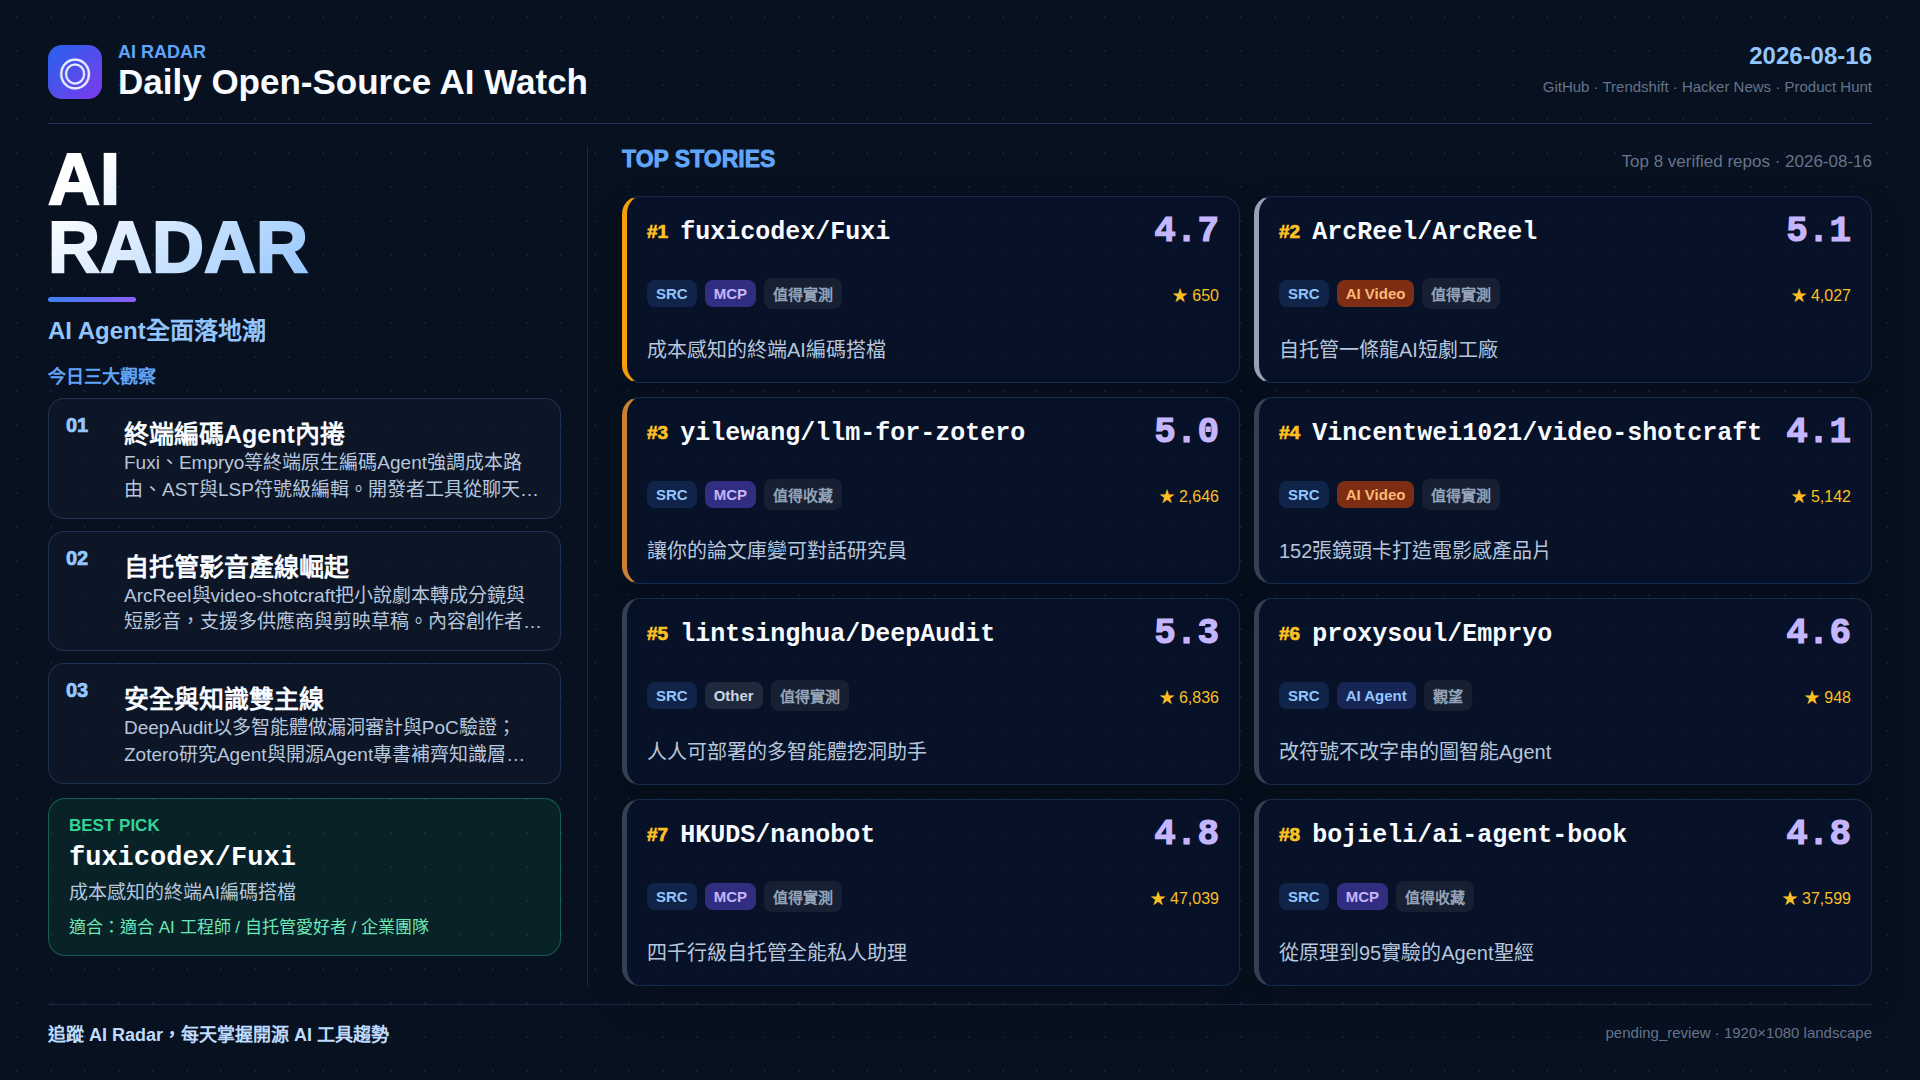
今天盤點的開源動態,幾乎可以用一句話概括:AI Agent 不再停在「會聊天、會補全」的展示層,而是正式擠進終端、編輯器、研究書庫、影片產線與安全審計現場。開發者工具開始把改碼、跑指令、成本路由與符號級編輯當成預設能力;內容創作者則要求從小說劇本一路走到分鏡、成片與剪映草稿,且最好可自部署、可追蹤費用;安全與知識側則出現多智能體漏洞挖掘、Zotero 研究代理,以及可讀可跑的 Agent 專書。這不是又一次概念熱潮,而是工作流被重寫的訊號:誰能把模型能力嵌進既有專業管線,誰就定義下一階段的生產力基準。今日榜單的共同母題,正是「可落地、可控制、可自托管」。
今天的趨勢
第一條主線,是終端原生編碼 Agent 的工程化。Fuxi、Empryo 這類專案不再把重點放在「再包一層 chat UI」,而是直接住進終端或桌面環境:讀程式庫、改檔、執行指令、串工具,並把成本路由、AST 與 LSP 符號級編輯寫進核心路徑。這代表開發者工具從「對話式補全」轉向「可自主改碼、可驗證結果的代理工作流」。成本感知尤其關鍵——長任務、多輪工具呼叫與多模型混用,若沒有路由與用量可見性,很快就變成帳單黑洞。符號級編輯則針對另一個長期痛點:字串級 find-and-replace 在重構時脆弱,AST/LSP 讓 Agent 以「函式、類別、符號」為單位操作,更接近人類工程師的心智模型。整體上,編碼 Agent 正在從助理變成可交代任務的協作者,評量標準也從回答是否漂亮,變成能否穩定完成可合併的變更。
第二條主線,是內容創作者對「可控、可自部署 AI 影片工作台」的明確需求。ArcReel 與 video-shotcraft 把小說、劇本或產品素材推進到分鏡、短影音甚至剪映草稿,並強調多供應商切換與流程可審核。這與早期「一鍵生成一段影片」的黑箱工具形成對照:創作者要的是角色一致性、鏡頭可回滾、成本可追蹤,以及產出物能接進既有後製軟體,而不是只能下載一段無法再編的成品。自托管降低了資料外流與供應商鎖定的焦慮,也讓團隊能依預算在不同影像/語音模型之間調度。簡言之,AI 影片正在從玩具變成產線節點,工作台形態比單次生成 API 更符合專業製作邏輯。
第三條主線,是實用落地與系統化學習並進。DeepAudit 用多智能體做漏洞審計與沙箱 PoC 驗證,把「找問題」和「證明問題可利用」串在同一平台;llm-for-zotero 把研究 Agent 深植進 Zotero 書庫,讓問答、摘要、比對文獻發生在研究者原本的知識底座上;nanobot 與 ai-agent-book 則分別從輕量框架與開源專書兩端,補齊「怎麼做」與「為什麼這樣做」的知識層。這說明社群已意識到:只有 demo 不夠,還需要可複現的安全流程、貼近真實資料的研究介面,以及可教學、可實驗的設計原則。今日的趨勢不是單一賽道爆發,而是編碼、內容、安全、研究、教育同時往「可操作的 Agent 系統」收斂。
Top 8 工具
#1 fuxicodex/Fuxi(Score: 4.7,MCP)
Fuxi 是終端內自包含的 AI 編碼代理,定位清楚:在 rich TUI 中驅動讀碼、改檔、跑指令與工具呼叫,並內建成本感知路由。它不是又一個 IDE 外掛聊天窗,而是把「開發者日常在終端完成的事」當成主戰場,適合需要長時間、多步驟任務且在意模型費用的工程師。評語:在 Agent 全面落地的節點上,Fuxi 抓住了兩個常被忽略的工程細節——終端原生體驗與成本可見性——這使它更像可長期並肩作戰的搭檔,而不只是偶發問句的補完器。對已習慣 CLI 工作流的人而言,學習曲線相對自然,也更容易嵌入既有腳本與自動化。
#2 ArcReel/ArcReel(Score: 5.1,AI Video)
ArcReel 是開源、可自托管的 AI 影片工作台,主打把小說、成品劇本或商品素材,轉成角色/場景/道具資產、分鏡、影片與剪映草稿,並支援跨鏡頭一致性、多供應商與費用追蹤。它把內容分析到匯出組織成可審核、可中斷恢復的流水線,對 AI 漫劇、說書短影音、廣告帶貨等場景有直接對應。評語:分數居高反映的是「產線完整度」而非單點生成品質口號;自托管加上剪映草稿匯出,對準的是創作者真正卡住的後半段——可控、可續編、可算帳。若你的痛點是黑箱一鍵片無法重來,ArcReel 的工作台思路比單純模型 playground 更務實。
#3 yilewang/llm-for-zotero(Score: 5.0,MCP)
llm-for-zotero 是深耕 Zotero 書庫的開源研究型 AI Agent 系統,讓使用者在讀者環境中直接提問、摘要論文、檢視圖表、比對來源,而不是把 PDF 反覆拖進通用聊天介面。它把 Agent 錨定在研究者已有的文獻管理習慣上,降低上下文搬運成本,也讓引用與館藏結構得以被利用。評語:研究場景最怕「模型很強、資料很散」。此專案選擇站在 Zotero 內部作戰,方向正確,分數也合理。對需要長期累積主題文獻、並以對話驅動閱讀節奏的研究生與分析師,它比泛用 RAG demo 更接近日常真相。
#4 Vincentwei1021/video-shotcraft(Score: 4.1,AI Video)
video-shotcraft 定位為面向 Claude 與 Codex 等編碼/代理環境的電影感產品影片 AI 技能包,強調把產品敘事轉成更具鏡頭語言的短片產製能力,而非只產出說明式畫面。它與完整工作台型專案互補:一個補技能與風格流程,一個補資產管線與部署形態。評語:分數略低於 ArcReel,反映的是定位差異——技能包更輕、邊界更聚焦,但在「讓 Agent 會拍產品片」這件事上夠具體。適合已有代理工作流、想快速為行銷或產品更新補上影像產出環節的團隊,而不是從零搭建整套自托管影音後台的人。
#5 lintsinghua/DeepAudit(Score: 5.3,Other)
DeepAudit 是開源多智能體代碼漏洞挖掘與沙箱 PoC 驗證平台,試圖把「掃描—推理—驗證」閉環化:不只標出可疑點,還在受控環境中驗證是否站得住腳。對安全工程與程式審計而言,PoC 驗證能過濾大量噪音,提升人工複核效率。評語:今日榜單最高分之一,凸顯社群對「可驗證安全 Agent」的重視。多智能體分工若設計得當,可比單一模組堆規則更有覆蓋面;但使用上仍須嚴守授權範圍與沙箱邊界,避免把驗證能力誤用到未授權目標。它代表 Agent 進入高風險專業域時,工程與治理必須同步升級。
#6 proxysoul/Empryo(Score: 4.6,AI Agent)
Empryo 是圖驅動的編碼 Agent,核心主張是編輯符號而非字串:以 AST 手術與完整 LSP 支援做重新命名、搬移、型別變更等操作,並強調程式結構的即時圖譜(code genome)。它提供桌面應用、終端 TUI 與 headless CI 等形態,意圖覆蓋互動開發與自動化管線。評語:若說 Fuxi 強調終端與成本,Empryo 則把賭注押在程式理解的結構正確性上。對大型重構與跨檔符號操作,這條路比纯文本 diff 更站得住。分數扎實,適合已受字串級 Agent 誤改所苦、願意擁抱 LSP/AST 工具鏈的團隊評估。
#7 HKUDS/nanobot(Score: 4.8,MCP)
nanobot 是超輕量、可自托管的個人 AI Agent Python 框架,核心迴圈精簡,卻具備推理、工具執行、記憶,以及多 LLM 供應商與 MCP 工具伺服器等要素。它適合想快速擁有「自己的代理」而不想像大型平台那樣運維一堆抽象層的開發者,也可作為教學與二次開發的底板。評語:輕量不是簡陋,而是把可讀性與可改性留在使用者手上。在 MCP 生態興起的背景下,nanobot 這類小而完整的框架,往往是個人自動化與私有工具串接的最短路徑。分數反映「低負擔落地」本身就是價值。
#8 bojieli/ai-agent-book(Score: 4.8,MCP)
ai-agent-book 是關於 AI Agent 設計原理與工程實踐的開源書,並附實驗程式碼,目標是把分散在部落格與論文裡的經驗,收成可系統閱讀、可動手驗證的材料。它補的是生態中常缺的一層:不只給你跑得起來的 repo,還解釋架構取捨、失敗模式與實作細節。評語:在落地潮裡,文件與教材型專案容易被低估,但它們決定社群能否複製成功經驗而非重複踩坑。4.8 分肯定的是「可學習性」對生態的槓桿作用。適合想從使用者變成設計者、或要在團隊內建立 Agent 工程共識的人。
今日首選
今日首選是 fuxicodex/Fuxi(成本感知的終端 AI 編碼搭檔,Score: 4.7)。選它不是因為分數絕對最高,而是因為它最能代表 2026 年中這波「Agent 全面落地」的工程共識:代理必須待在開發者真正工作的地方,必須能改碼與執行,必須把模型成本當成一等公民。
Fuxi 的產品形狀是自包含的終端編碼代理:以 TUI 驅動,讀取程式庫、編輯檔案、執行命令並串接工具,同時強調跨 LLM 的成本感知路由。這組合直接回應三個現實約束。第一,IDE 聊天適合局部問答,但長程任務、腳本化操作與遠端環境仍高度依賴終端;終端原生降低了上下文切換。第二,Agent 若只能「建議 diff」而不能跑測試、看輸出、再迭代,就仍停留在助手階段;能跑指令才有閉環。第三,多模型時代「一律用最強最貴」不可持續,路由與費用可見性決定 Agent 能否成為日常預設,而非偶爾炫技。
與同日上榜的 Empryo 對照,兩者其實互補:Empryo 把結構編輯做深,Fuxi 把終端工作流與成本治理做實。首選 Fuxi,是因為對更廣大的開發者群體而言,「願意每天打開」的前提往往是環境熟悉、回饋即時、帳單可控;符號級編輯是進階正確性,成本路由則是採用門檻。當然,Fuxi 並非萬能:團隊若強依賴圖形化重構視覺化或嚴格的符號級保證,仍應並讀 Empryo 一類方案;若場景是影音產線或文獻研究,則應看 ArcReel 或 llm-for-zotero。但就「AI Agent 全面落地」這個總標題,Fuxi 提供的是最可遷移的範式——把代理嵌進既有專業界面,並用工程手段管住效果與成本。這也是為何它成為今日 Best Pick:不是最吵,而是最像能留下來的那一種工具。
評分方式說明
AI Radar 評分綜合多個可觀察維度,採加權後落在約 1–6 分的相對量表,用於當日橫向比較而非絕對排行榜終身制。主要維度包括:專案完整度與可運行性、與當日趨勢主題的契合程度、工程創新(例如成本路由、AST/LSP、多智能體驗證、自托管工作流)、文件與可維護性訊號、社群與活躍度線索,以及是否具備可複用的介面生態(如 MCP)。分數高代表「今日語境下值得優先關注」,不代表生產環境免審核、無風險或適用所有團隊。選題與排序亦可能納入編輯對落地價值的判斷;讀者應回到授權條款、安全性、維運成本與自身場景再做採用決策。本說明為固定方法論摘要,實際權重可能隨資料品質微調,但不會以單一星數或行銷敘事取代技術檢視。
結語與 CTA
AI Agent 的主場,已從示範影片回到終端、書庫、產線與審計沙箱。若你正在選工具,建議先對齊自己的工作界面與約束(成本、自托管、可驗證性),再從今日 Top 8 挑一條主線深挖。歡迎收藏本篇、把 Fuxi 與你的終端工作流做小範圍試點,並持續追蹤 AI Radar,獲取下一輪可落地的開源信號與編輯觀點。