AI Radar Daily 2026-08-17
先查證今日榜上主要專案的公開資訊,再撰寫符合字數與結構要求的深度分析。--- title: "AI RADAR DAILY 2026-08-17 — 本地優先語音與代理浪潮" date: 2026-08-17 status: pending_review tags: [AI, Agent, MCP, RAG, Automation, 開源工具] word_count: ~2850
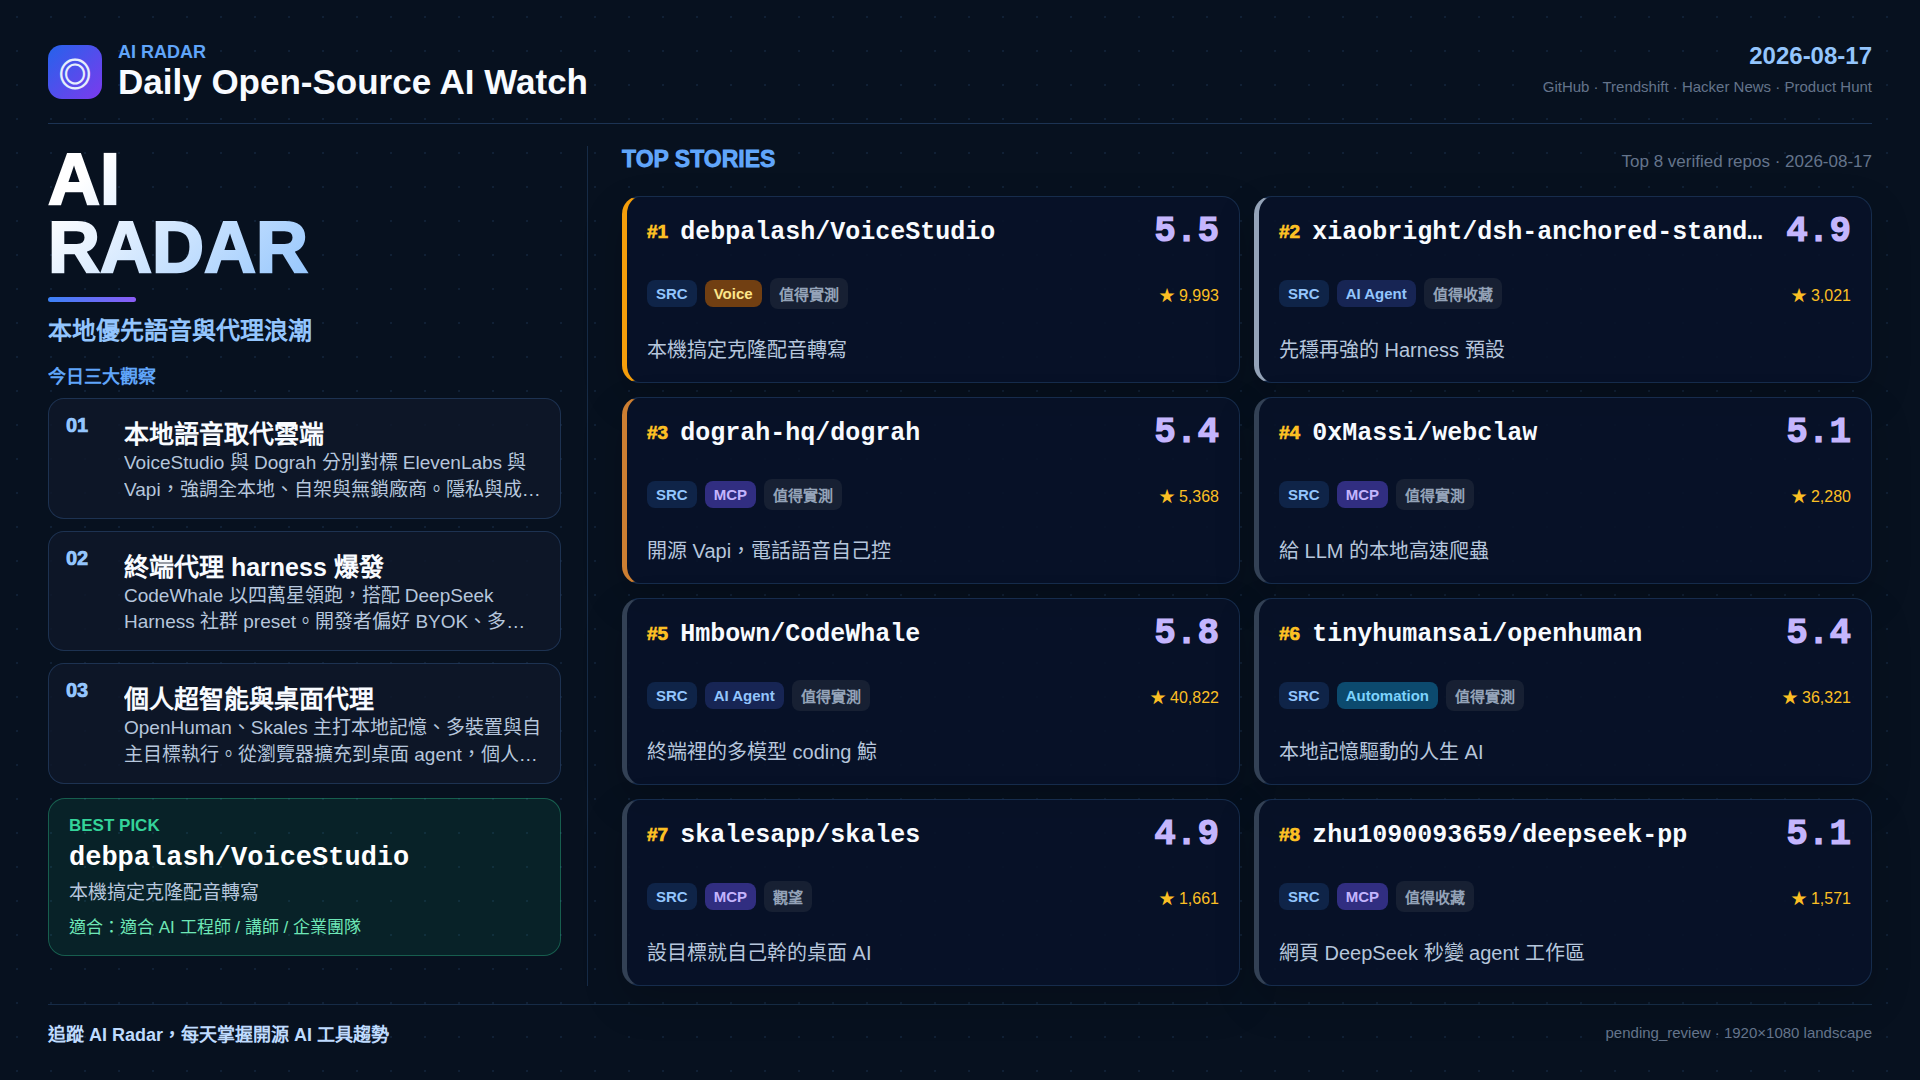
今天的開源動態並非又一次模型參數競賽,而是一條更清晰的產品路線:語音與代理能力正在從雲端 API 依賴,轉向可自架、可離線、可 BYOK 的本地優先架構。VoiceStudio 以全本地克隆、配音、轉寫與有聲書流程直接對標 ElevenLabs;Dograh 則以視覺化工作流與 MCP 原生設計,成為 Vapi、Retell 路線的開源自架選項。同步出現的是 coding harness 與個人桌面 agent 的生態化:CodeWhale 以約四萬星體量帶動多模型切換與工具編排,OpenHuman、Skales 則把長期記憶、多裝置與自主目標執行推到個人工作站層級。隱私邊界、單位成本與供應商鎖定風險,已從次要考量變成選型主軸;企業合規與創作者產能需求,在同一天的榜單上同時被滿足。
今天的趨勢
第一條主軸是語音 AI 的「去鎖廠商化」。過去一年,ElevenLabs、Vapi、Retell 等雲端服務以品質與整合速度佔據心智,但按量計費、資料出境與 SLA 不可控,開始成為規模化採用的摩擦點。今日榜上,VoiceStudio 強調無帳號、無 API Key、無雲端即可完成克隆、設計、配音、口述、轉寫與多語有聲書;Dograh 則以 on-prem、BYOK(語音對語音或 LLM/STT/TTS 任意組合)、視覺工作流與電話系統支援,把「可上線的語音 agent」從黑盒平台拆成可部署堆疊。隱私與成本不再只是行銷話術,而是可驗證的架構選擇:音訊與對話留在自有環境,模型與線路可替換,邊際成本從「每分鐘帳單」轉為「算力與維運」。企業客服、內部知識語音入口與創作者批次產製,會因此重新評估自架與否。
第二條主軸是開發者對 agent harness 的偏好定型:BYOK、多模型熱切換、可擴充工具編排,以及可被社群複製的 preset。CodeWhale 以開源終端 coding agent harness 領跑,搭配 DeepSeek 相關社群配置(含 dsh-anchored-standard 這類兩階段 Minimal → Standard 的穩定化路徑),說明「會寫 code 的 agent」已從單一 CLI 演示,演進為可配置、可回滾、可權限治理的工作台。開發者不願被單一 frontier 模型綁死,也不願每次從零拼 prompt 與工具協議;他們要的是同一套 harness 下切換供應商、掛載 MCP、共享社群配方。生態成型的速度,往往比單一 benchmark 分數更能決定誰成為預設底座。
第三條主軸是個人 AI 從「對話視窗」走向「長期記憶 + 多代理協作 + 跨裝置執行」。OpenHuman 主打本地加密記憶、多代理編排與深度研究;Skales 強調跨平台桌面 agent 與背景目標自主推進;deepseek-pp 則把 MCP、記憶與自動化工作區嵌進瀏覽器擴充。路徑很清楚:瀏覽器擴充解決當下網頁情境,桌面 agent 接管檔案、行事曆與系統工具,記憶層讓上下文跨 session 存活,多代理把研究、執行、審核拆成可協作單元。這與企業語音自架並非兩條平行宇宙,而是同一邏輯在不同介面的投影——控制權回到使用者側,雲端變成可選加速器而非唯一跑道。
三條線交會後,今日訊號可以收斂成一句話:2026 年中的開源 AI,競爭焦點已從「誰的模型更強」部分轉移到「誰能在本地與自架條件下,把語音、編碼與個人代理做成可維運產品」。
Top 8 工具
#1 debpalash/VoiceStudio(Score: 5.5,Voice)
全本地 ElevenLabs 替代方案,涵蓋語音克隆、voice design、影片配音、口述輸入、轉寫與有聲書產製,並強調多語支援與「No accounts, no API keys, no cloud」的產品邊界。對創作者與內製工作室而言,價值在於把高頻、高敏感的聲音資產留在本機,並以一次建置換長期批次產能,而非按字元或按分鐘持續付費。技術形態上同時照顧桌面與瀏覽器 UI、發行包與 Docker 等部署路徑,降低從試用到固定工作流的門檻。評分落在語音類前段,反映的是完整度與替代雲端旗艦的清晰定位,而非單一 demo 熱度。若團隊已有 GPU 或 Apple 本地加速環境,它是今日最值得優先驗證的語音工作站選項。
#2 xiaobright/dsh-anchored-standard(Score: 4.9,AI Agent)
面向 DeepSeek Harness 的兩階段社群 preset:先以 Minimal 取得可運行、低噪音的基線,再升至 Standard 打開較完整的工具與行為約束。這類 repo 的意義不在炫技,而在把「能跑」與「能穩」拆成可複製步驟,減少每人從零調參的隱性成本。對已採用 CodeWhale 或同類 harness、並以 DeepSeek 為主力或備援模型的開發者,它提供的是配置紀律與升級路徑,而不是又一個從空白開始的 agent 殼。評分接近 5.0,顯示社群對「可分享的穩定配方」需求真實存在。建議與主 harness 文件對照使用,避免 preset 與核心版本漂移造成行為不一致。
#3 dograh-hq/dograh(Score: 5.4,MCP)
開源、可自架的語音 AI 平台,明確對標 Vapi 與 Retell:視覺化工作流建構、快速測試、MCP 原生,以及 on-prem 與 BYOK(Speech-to-Speech 或 LLM/STT/TTS 組合),並涵蓋電話等上線常見元件。與純 TTS 工具不同,Dograh 處理的是「可進線、可編排、可維運的語音 agent 系統」,更接近產品與營運層。對不想把通話音訊與業務對話交給單一 SaaS 的團隊,自架意味著資料平面與模型選擇權回收,同時仍可用雲端託管作為對照路徑。Score 5.4 反映其在 MCP 與語音平台交叉帶的完整度。評語:若你的痛點是「語音 agent 要上線且要可控」,優先看它;若只是內容配音,應回 VoiceStudio。
#4 0xMassi/webclaw(Score: 5.1,MCP)
以 Rust 打造的本地優先網頁擷取工具,聚焦爬取、結構化輸出,並以 MCP 對外暴露能力,讓 agent 在編排層直接呼叫。網頁仍是代理系統最常碰到的髒資料來源之一;把擷取與結構化做成本地、可組合的 MCP 服務,比在每個 agent 內重寫爬蟲更符合長期維護。Rust 取向通常對應性能與部署體積上的可控性,適合當工具鏈中的「資料入口」而非聊天前端。評分 5.1 顯示它在 MCP 工具層有穩定能見度。評語:適合與 coding agent 或研究型 agent 搭成管道;單獨使用時,要先確認目標站點的合規與頻率限制,工具再強也不能替代使用政策判斷。
#5 Hmbown/CodeWhale(Score: 5.8,AI Agent)
開源、社群驅動的終端 coding agent harness,支援多模型與 BYOK,星數約四萬量級,是今日榜上綜合分最高者(5.8)。它代表的產品形態是:開發者在終端完成讀碼、改碼、工具呼叫與權限邊界,模型供應商可替換,行為與設定可版本化、可回滾。與「單一模組聊天外掛」相比,harness 競爭的是預設工作流、擴充面與社群配方密度;DeepSeek 相關 preset 能快速傳播,正是因為底座夠統一。評語:若你的日常是 repo 內密集工程,CodeWhale 應列入預設候選;導入時應同步建立密鑰、權限與 telemetry 政策,避免高能力 agent 在本地擁有過寬系統面。它是今日開發者代理浪潮的中軸項目。
#6 tinyhumansai/openhuman(Score: 5.4,Automation)
定位為個人向「超智能」助理:本地記憶、多代理編排、深度研究,並強調技能/整合擴充與在個人裝置上長期運行。與 coding harness 不同,OpenHuman 更靠近生活與知識工作的連續上下文——記憶是否加密落地、能否編排多個子代理、能否接上郵件與知識工具,決定它是不是「會忘的聊天機器人」。GPL 開源與桌面端形態,使其在隱私敏感使用者中具說服力。Score 5.4 與其在自動化/個人代理分類的完整敘事相符。評語:適合需要跨任務記憶與研究流程的知識工作者;企業導入前仍需檢視技能生態授權、資料流向與端點模型是否符合內控。它是「個人 AI 作業系統化」路線的代表之一。
#7 skalesapp/skales(Score: 4.9,MCP)
跨平台個人桌面 AI agent,強調在自有電腦上運行、連接多種模型(含本地 Ollama/LM Studio 等),並以背景目標、工具集與真實工作(郵件、瀏覽、程式、媒體等)為核心,而非單次問答。產品敘事清楚對照「要 VPS、要 daemon、要重環境」的代理方案,改以接近一般應用程式的安裝與使用體驗降低門檻。對希望 agent 長駐、能追目標並橫跨系統能力的使用者,Skales 補上了從瀏覽器擴充到完整桌面執行層的缺口。評分 4.9 顯示認知度與完整度已在前線,但仍略低於生態最成熟的 harness/平台。評語:個人生產力場景優先試用;權限模型與自動執行邊界必須先設嚴,再談自治程度。
#8 zhu1090093659/deepseek-pp(Score: 5.1,MCP)
DeepSeek 生態下的瀏覽器擴充路線:把 MCP、記憶與自動化工作區帶進日常上網情境,讓「當頁即代理」成為可能。相較桌面 agent 的重安裝與系統權限,擴充形態啟動成本低,適合研究、填表、摘要與輕量工作流的第一接觸點。它與 deepseek-pp 所處的 MCP 標籤一致:重點是可被其他工具編排、可延續記憶,而不只是側邊欄聊天。Score 5.1 反映瀏覽器仍是代理分發的高效管道。評語:可作為 OpenHuman/Skales/CodeWhale 的前端觸點或輕量替代;涉及帳號與企業 SaaS 操作時,仍須注意擴充權限與頁面腳本風險。適合想快速把 DeepSeek 能力嵌進瀏覽習慣的使用者。
今日首選
Best Pick:debpalash/VoiceStudio
選擇 VoiceStudio 而非分數略高的 CodeWhale,是基於「趨勢代表性 + 可立即感知的替代價值」。今日整體敘事是本地優先語音與代理浪潮;在語音側,能同時覆蓋克隆、設計、配音、轉寫、口述與有聲書、並以全本地為預設的產品並不多,VoiceStudio 把對標對象寫得很清楚:ElevenLabs 等級的工作流,卻不預設雲端與按量帳單。對創作者,這直接關係到聲音品牌資產是否上傳第三方;對企業培訓、內部媒體與多語內容團隊,這關係到合規審核能否通過。桌面發行、來源建置與容器化路徑並存,代表它不是只能 demo 的研究倉庫,而是朝可安裝產品收斂。
與 Dograh 相比,兩者都服務「語音」,但層次不同:VoiceStudio 偏內容與人聲產製工作站,Dograh 偏可進線的語音 agent 平台。今日首選給 VoiceStudio,是因為其用戶價值路徑更短——下載或建置後即可在本機驗證品質與隱私假設,不必先接電話網或複雜編排。若你的下一季 KPI 是內容產能與聲音一致性,它應排在驗證清單第一位;若 KPI 是客服通話自動化,則應並列評測 Dograh。首選不是唯一答案,而是對今日趨勢最鋒利的切片:本地、完整、可替代雲端旗艦。
評分方式說明
AI Radar 分數為編輯綜合指標,並非單一星數排行。權重大致涵蓋:專案完整度與可安裝性、與當日趨勢的契合程度、技術路線清晰度(如本地/BYOK/MCP)、社群與維護訊號,以及可複用的工程或產品價值。分數用於同一日榜單內的相對排序與閱讀導引,不構成投資、採購或安全背書。上榜項目仍應自行檢視授權條款、權限模型、依賴供應鏈與實際負載下的品質表現。repo 名稱保留英文原名,便於檢索與引用。
結語與行動
若你只做一件事:今天先用真實素材跑通 VoiceStudio 的克隆與轉寫流程,並另開一條線用 CodeWhale 或 Dograh 驗證「BYOK + 自架」是否接得上現有堆疊。把隱私、成本與鎖定風險寫進選型表,比追下一則星數更有用。歡迎回報你在本地語音或代理 harness 上的實測結論,我們會在後續 Radar 持續追蹤這條本地優先曲線。