AI RADAR DAILY 2026-08-18 — 代理工具走向可執行
今天最值得注意的,不是哪一個模型又提高了基準分數,而是開源工具開始更認真處理「把事情做完」這件事。過去一年,AI 工具的主戰場多半是對話品質、程式生成與文件摘要;但當模型接上終端機、Git、瀏覽器登入態、爬蟲框架與本機檔案系統後,真正的難題立刻浮現:它能否安全執行?能否留下可追蹤紀錄?遇到變動網頁、模糊需求或既有專案規範時,能否穩定完成任務而不是只產出一段看似合理的文字?
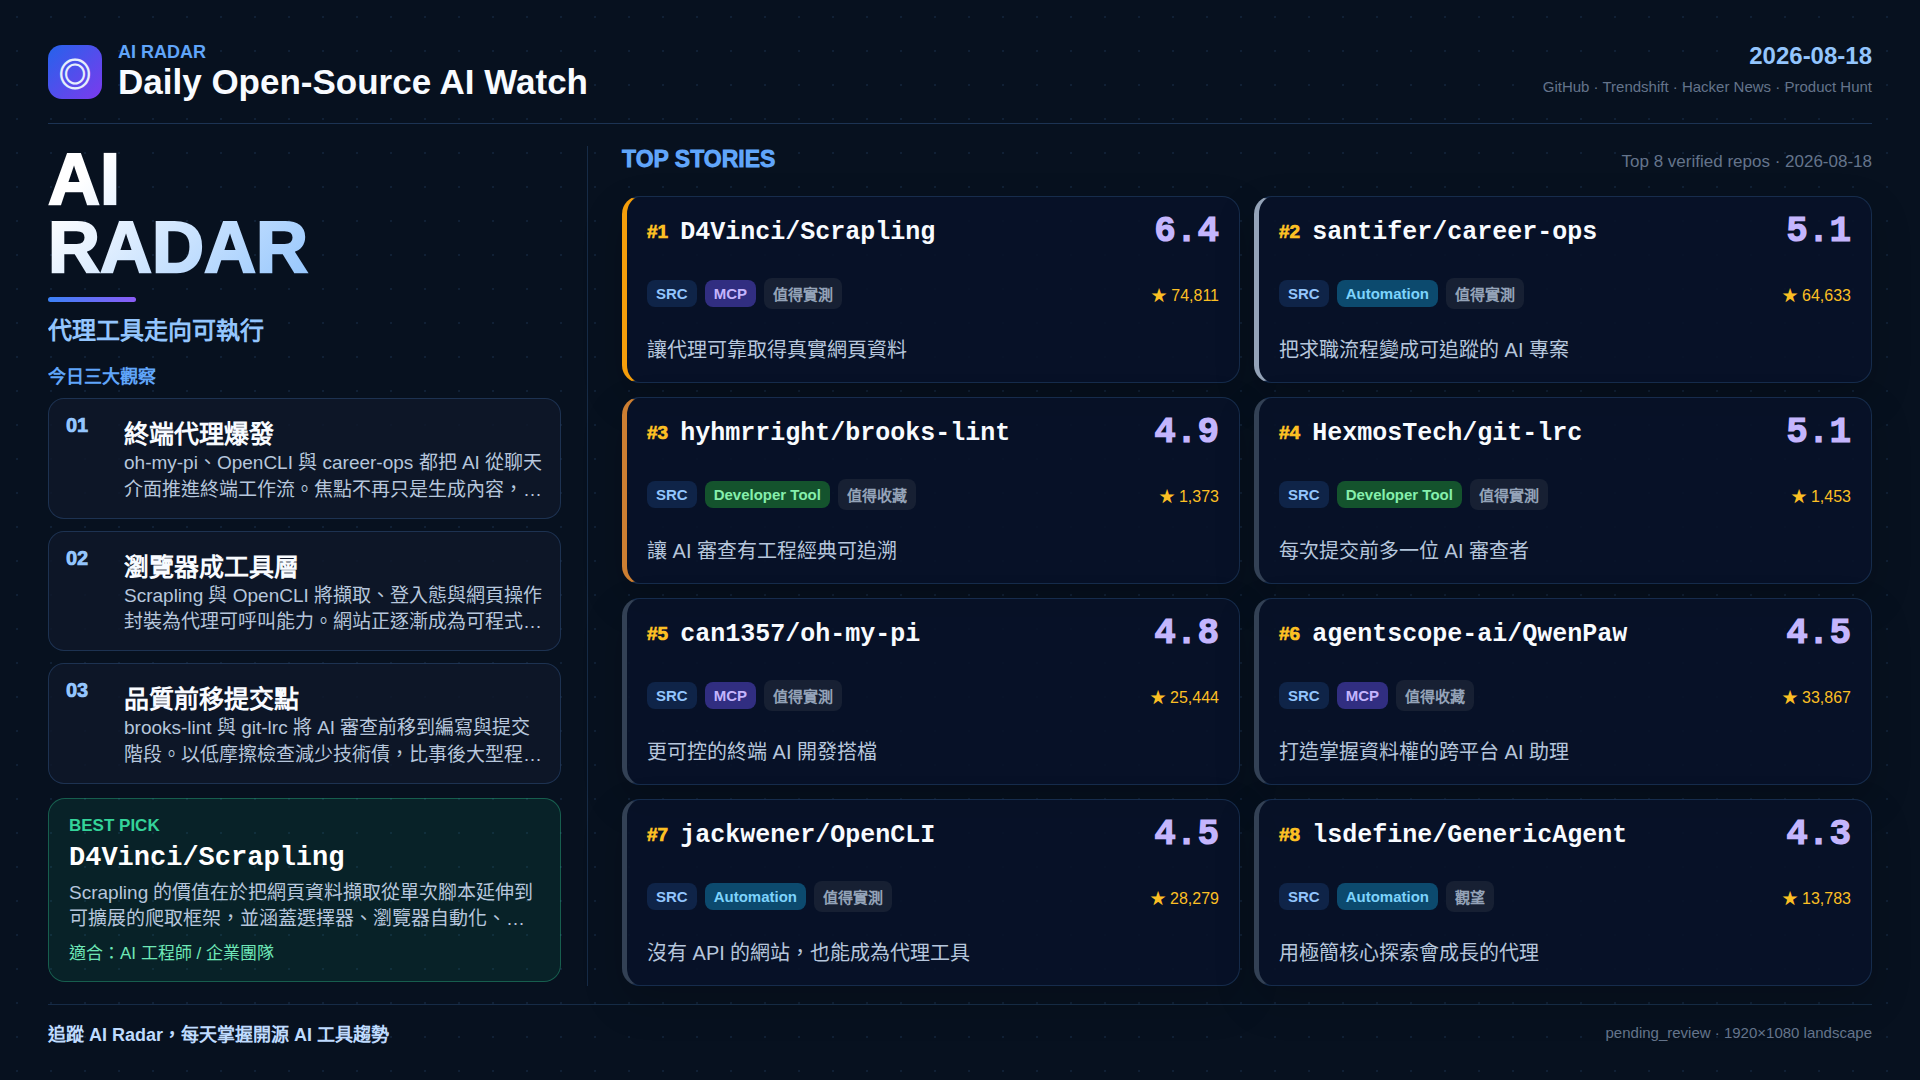
2026-08-18 的 AI Radar 顯示,代理工具正在從「回答者」變成「操作者」。D4Vinci/Scrapling 把網頁擷取升級為可長期運作的資料能力;OpenCLI 將網站與登入瀏覽器轉譯為代理可調度的命令列介面;career-ops 則把求職這種跨資料搜集、評估與文件客製化的流程搬進本機 AI 編碼工具。另一端,brooks-lint 與 git-lrc 沒有嘗試打造全能代理,而是把 AI 檢查塞進開發者本來就會經過的編寫與提交節點。這是一個更務實的方向:AI 的價值不在於取代人類按下每個按鈕,而在於讓流程中的判斷、執行與回饋形成更短、更可靠的閉環。
今天的趨勢:代理工具走向可執行
第一個洞察是,終端工作流正在成為代理能力真正落地的介面。oh-my-pi、OpenCLI 與 career-ops 都指向同一件事:聊天視窗適合討論,但不適合承載完整工作。真實任務往往需要讀取本機檔案、呼叫工具、保存中間結果、比較版本差異、登入服務,以及在失敗後重新嘗試。終端機的優勢不是懷舊,而是它天生具備組合性、可記錄性與可自動化性。代理若能在明確權限與可觀察輸出的前提下操作 CLI,就能從「幫你寫一個指令」前進到「依照工作規則執行一串指令」。
第二個洞察是,網站正逐漸變成可程式化、可組合的工作介面。Scrapling 與 OpenCLI 分別從資料擷取和網頁操作切入,但底層命題相同:代理必須能讀懂外部世界,而不是只依賴預先整理好的 API 或靜態知識庫。問題在於,網站不是乾淨的資料表。它有 JavaScript 渲染、登入狀態、反自動化機制、版面改動與不穩定選擇器。能將這些摩擦封裝為相對穩定能力的工具,才有機會支撐研究、競品監測、商情蒐集、知識庫更新與半自動營運。這也意味著未來的代理基礎設施,不只包括模型、向量資料庫與 MCP,還包括可靠的網頁存取層。
第三個洞察是,AI 程式碼審查正往流程前端移動。brooks-lint 與 git-lrc 的重要性不在於它們能否取代資深工程師,而在於它們選擇了低摩擦的介入時機:寫完一段程式時,以及準備提交版本時。大型 PR 審查往往太晚、太昂貴,也容易因為上下文龐大而失焦。相對地,在提交前攔下命名失準、架構異味、複雜度膨脹或明顯違反團隊慣例的問題,成本更低,也更容易形成長期習慣。AI 的最佳位置未必是最後裁判,而可能是每次變更之前都在場的第一道工程護欄。
Top 8 工具
#1 D4Vinci/Scrapling|Score: 6.4|MCP
Scrapling 是今日評分最高的專案,定位是從單頁資料擷取一路延伸到大規模網頁爬行的自適應框架。它不只提供傳統選擇器式抓取,也涵蓋瀏覽器自動化、反偵測與更適合代理串接的能力。對 AI 產品而言,外部資料通常是最脆弱的一環:模型可以推理,但若輸入資料失效、過期或抓錯頁面,後續流程再漂亮也沒有意義。Scrapling 的價值在於把「取得可靠網頁資料」當成系統能力,而非一次性的腳本任務。評語:適合需要長期研究、追蹤多來源資訊或建置動態知識庫的團隊,但導入時仍應明確處理網站條款、速率限制與資料治理。
#2 santifer/career-ops|Score: 5.1|Automation
career-ops 將求職流程帶入本機 AI 編碼工具,涵蓋職缺搜尋、職缺評分、履歷客製化與相關任務編排。它的亮點不是把履歷寫得更華麗,而是把原本散落在求職網站、筆記、文件與人工判讀中的工作重新串起來。求職本質上是一個高重複、但又需要個人化判斷的流程,正好適合以代理輔助。評語:這類工具若只追求大量投遞,很容易把使用者推向低品質自動化;career-ops 更值得採用的方式,是把它當成研究與決策輔助,保留人類對職涯方向、公司文化與內容真實性的最終控制權。
#3 hyhmrright/brooks-lint|Score: 4.9|Developer Tool
brooks-lint 以經典軟體工程書籍中的觀點驅動 AI 程式碼審查與修正,主張不是單純找出語法錯誤,而是用長期有效的工程原則檢視設計與複雜度。這個方向很有意思,因為許多 AI 審查工具只是在輸出通用建議,容易變成「可以考慮重構」式噪音。若能把審查準則錨定在明確、可辯論的工程思想,建議就更容易被團隊理解與採納。評語:它的成敗取決於規則是否能貼合專案脈絡;工程經典提供的是判斷框架,不應被誤用為跨所有語言與架構的硬性教條。
#4 HexmosTech/git-lrc|Score: 5.1|Developer Tool
git-lrc 將輕量 AI 程式碼審查放進 Git 提交流程,讓開發者在變更正式進入版本歷史前就獲得回饋。這種設計比事後的大型審查更符合日常節奏:提交是每位工程師都會經過的固定節點,因此不需要另開平台、不必等待 reviewer,也不會因為任務切換而中斷。評語:git-lrc 的核心競爭力是低摩擦,而不是評論越多越好。真正好的 pre-commit AI 檢查應該優先報告高信號問題,並允許團隊調整門檻、略過規則與保護敏感程式碼,否則很快就會被開發者視為必須繞過的阻力。
#5 can1357/oh-my-pi|Score: 4.8|MCP
oh-my-pi 是一個終端 AI 編碼代理,提供雜湊編輯、LSP 整合與子代理能力。這組功能反映了編碼代理逐漸成熟的必要條件:它不只要能產生程式碼,還必須能精準修改既有檔案、理解語言伺服器提供的結構資訊,並將大型任務拆分為可平行或可驗證的子工作。雜湊編輯尤其值得注意,因為它試圖降低代理在修改長檔案時誤傷不相關內容的風險。評語:終端代理的上限很高,但風險也同樣高。團隊應優先評估權限邊界、命令確認、差異檢視與測試回饋,而不是只比較它一次能產生多少程式碼。
#6 agentscope-ai/QwenPaw|Score: 4.5|MCP
QwenPaw 是可自架的個人 AI 助理與技能框架,並支援多個聊天平台。它代表另一條代理落地路線:不是把 AI 限定在單一網頁產品,而是讓使用者能在既有溝通管道中呼叫技能、串接本機或自有服務。自架特性對重視資料控制、客製工作流與私有部署的使用者尤其重要。評語:多平台支援固然方便,但真正的挑戰是能力治理。當同一位助理可以在不同訊息入口執行工具時,身份驗證、授權範圍、提示注入防護與稽核紀錄都必須先設計好,否則便利性會快速轉化為維運負擔。
#7 jackwener/OpenCLI|Score: 4.5|Automation
OpenCLI 的目標是把網站、已登入的瀏覽器與本機工具轉換成代理可操作的 CLI。這個概念看似直接,實際上觸及了代理應用最關鍵的斷點:大量服務沒有適合自動化的 API,但人類每天都透過瀏覽器完成工作。若能把網頁操作以命令列方式描述、封裝並重複使用,代理就不必每次重新理解介面。評語:OpenCLI 值得關注的不是「讓 AI 幫你點網頁」,而是它是否能建立可驗證、可重播、可限制的網頁操作層。登入態與帳號權限極為敏感,採用前應先從低風險、可撤銷的任務開始。
#8 lsdefine/GenericAgent|Score: 4.3|Automation
GenericAgent 以極小核心與技能樹機制打造可自我演化的自主代理。它的吸引力在於不預設一個龐大、封閉的代理框架,而是將能力拆成可逐步擴充的技能結構。這種設計有助於讓使用者從小任務開始,根據實際需求增加工具、記憶、規則與工作流,而不是一開始就被複雜架構綁住。評語:極小核心通常帶來較高的可塑性,但也把更多設計責任交回使用者。對個人實驗與研究很有吸引力;若要進入正式團隊環境,仍需補上可觀測性、權限控管、錯誤復原與技能品質管理。
今日首選:D4Vinci/Scrapling
今日首選是 D4Vinci/Scrapling,因為它處理的是代理系統最常被低估、卻最決定成敗的基礎問題:外部資訊如何可靠進入系統。許多 AI 應用把重心放在模型選型、提示詞與 RAG 架構,但真正部署後經常發現,資料來源比模型更不穩定。網頁版型一改、內容改為動態載入、選擇器失效、反自動化機制升級,整條研究或監測流程就會中斷。
Scrapling 的價值在於,它不是把爬蟲當成一支臨時腳本,而是提供從簡單擷取到規模化爬取的延續性能力。選擇器、自適應擷取、瀏覽器操作與反偵測並不是彼此獨立的功能清單,而是同一個需求的不同層次:讓系統能在真實、變動且不完全友善的網頁環境中持續取得可用資料。對 MCP 與代理工具鏈而言,這尤其重要,因為模型可以決定「要找什麼」,但仍需要一個可靠執行層回答「資料在哪裡、如何取得、結果是否完整」。
更具體地說,Scrapling 可支撐競品追蹤、新聞與研究監測、商品資料同步、職缺聚合、法規變動觀察,以及動態知識庫更新等場景。它不會自動解決資料品質、法規合規或來源可信度問題,但它讓團隊有能力把這些問題放到可管理的工程流程中處理。若要選一個能廣泛接入 AI 產品、又不依賴單一模型供應商的底層工具,Scrapling 在成熟度、適用面與整合潛力之間取得了相對均衡的位置。
評分方式說明
AI Radar 採用固定評估框架,分數不是單看 GitHub 熱度,也不等同於專案絕對品質。本日評分綜合考量五個面向:第一,問題的重要性與市場需求;第二,功能完整度與可實際執行性;第三,整合潛力,包括 CLI、MCP、API、Git 與既有工作流的相容程度;第四,技術成熟度與可維護性;第五,差異化程度,也就是它是否真的提出更有效的解法。
分數較高代表該專案在當前代理工具趨勢中更值得優先研究,不代表所有團隊都應立即導入。實際採用仍應回到自身情境:資料敏感性、部署方式、權限模型、團隊技術棧、維運成本與可接受風險。AI 工具最容易犯的錯誤,是把展示效果當成生產能力;評分的目的,是協助讀者優先辨識那些更接近可落地價值的專案。
代理工具的下一階段,不會由最會說話的模型決定,而會由最能安全接入真實工作、最容易被團隊驗證與最能持續維護的工具決定。若你正在建置 AI 研究流程、內部自動化或編碼代理,建議從 Scrapling、OpenCLI 與 git-lrc 這三種不同層次的切入點開始:先取得可靠資料,再建立可控執行,最後把品質檢查前移到日常流程。